Come si confrontano SynaLemma e Synalog con NVIDIA Auto-Ontology?
Entrambi pongono un layer semantico tra gli agenti di IA e i vostri database. Differiscono per che cosa sia quel layer e per che cosa lo verifichi.
In Auto-Ontology, il layer è un glossario di termini, corrispondenze di colonne e frammenti SQL memorizzati in un database. Al momento della domanda viene recuperato e passato a un modello linguistico come indicazione, e il modello scrive un nuovo SQL per ogni risposta. Una seconda chiamata al modello giudica poi se quel SQL è corretto. Un sistema probabilistico che ne controlla un altro non offre alcuna garanzia: entrambi possono sbagliare nello stesso modo.
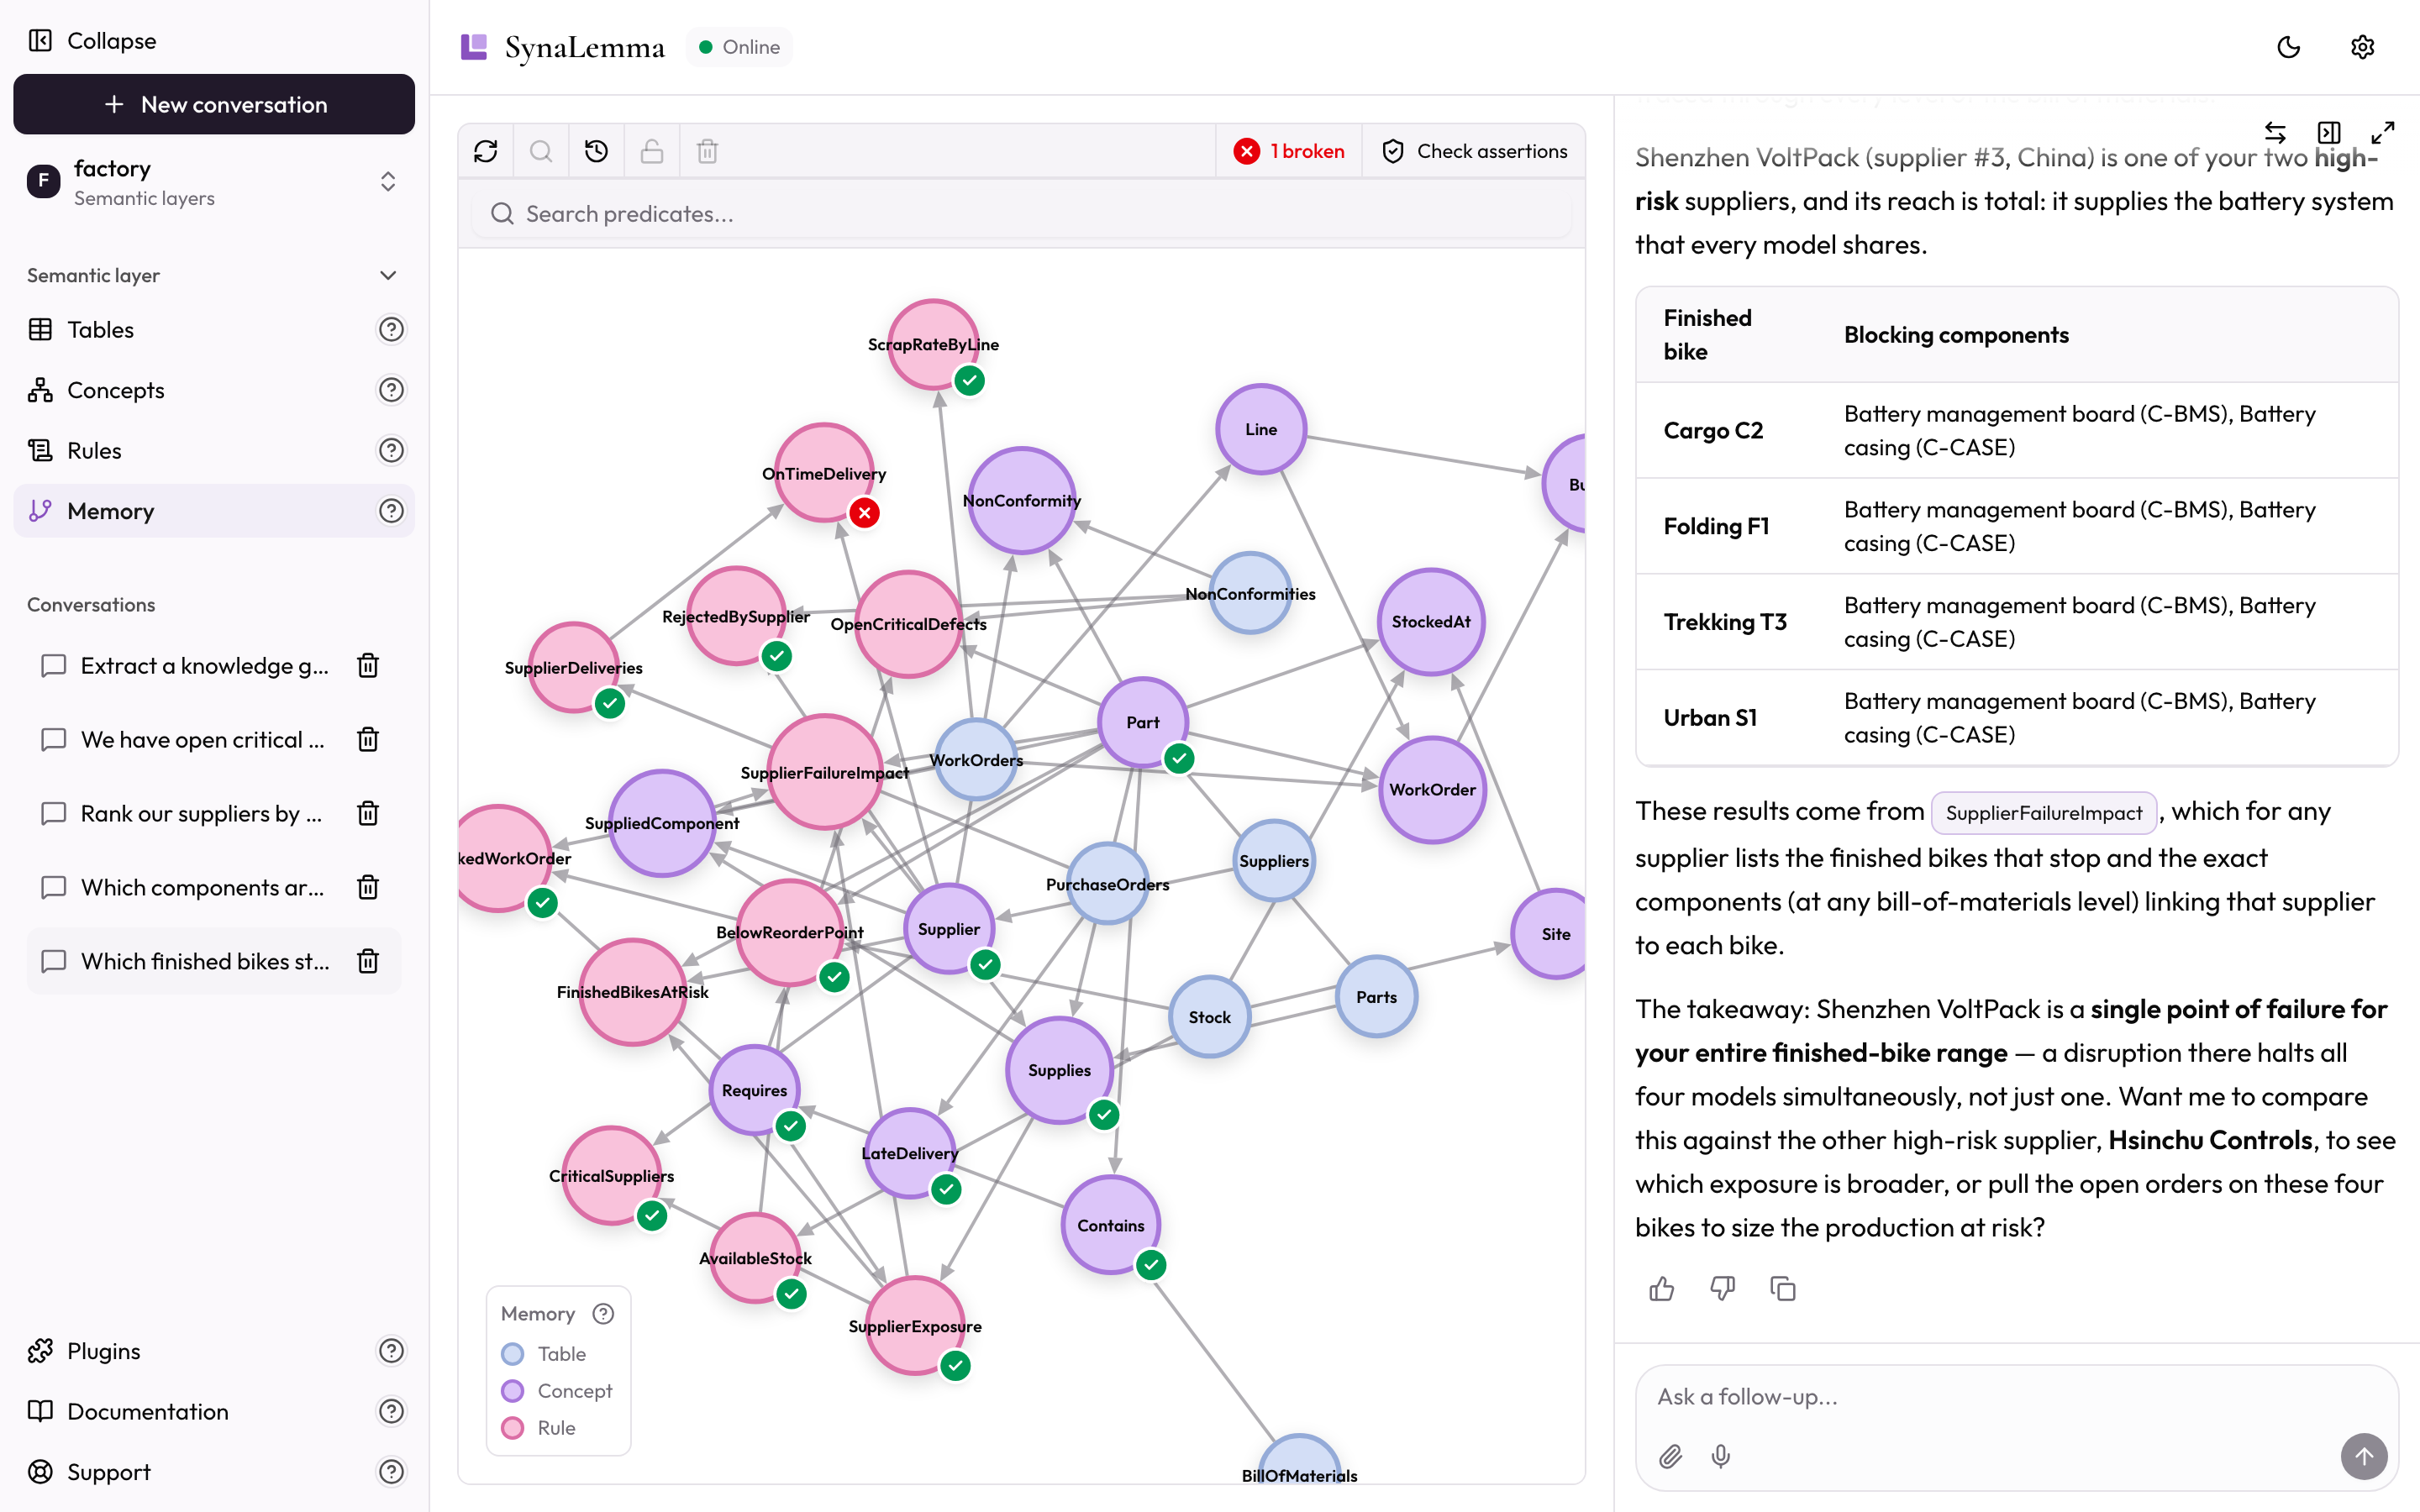
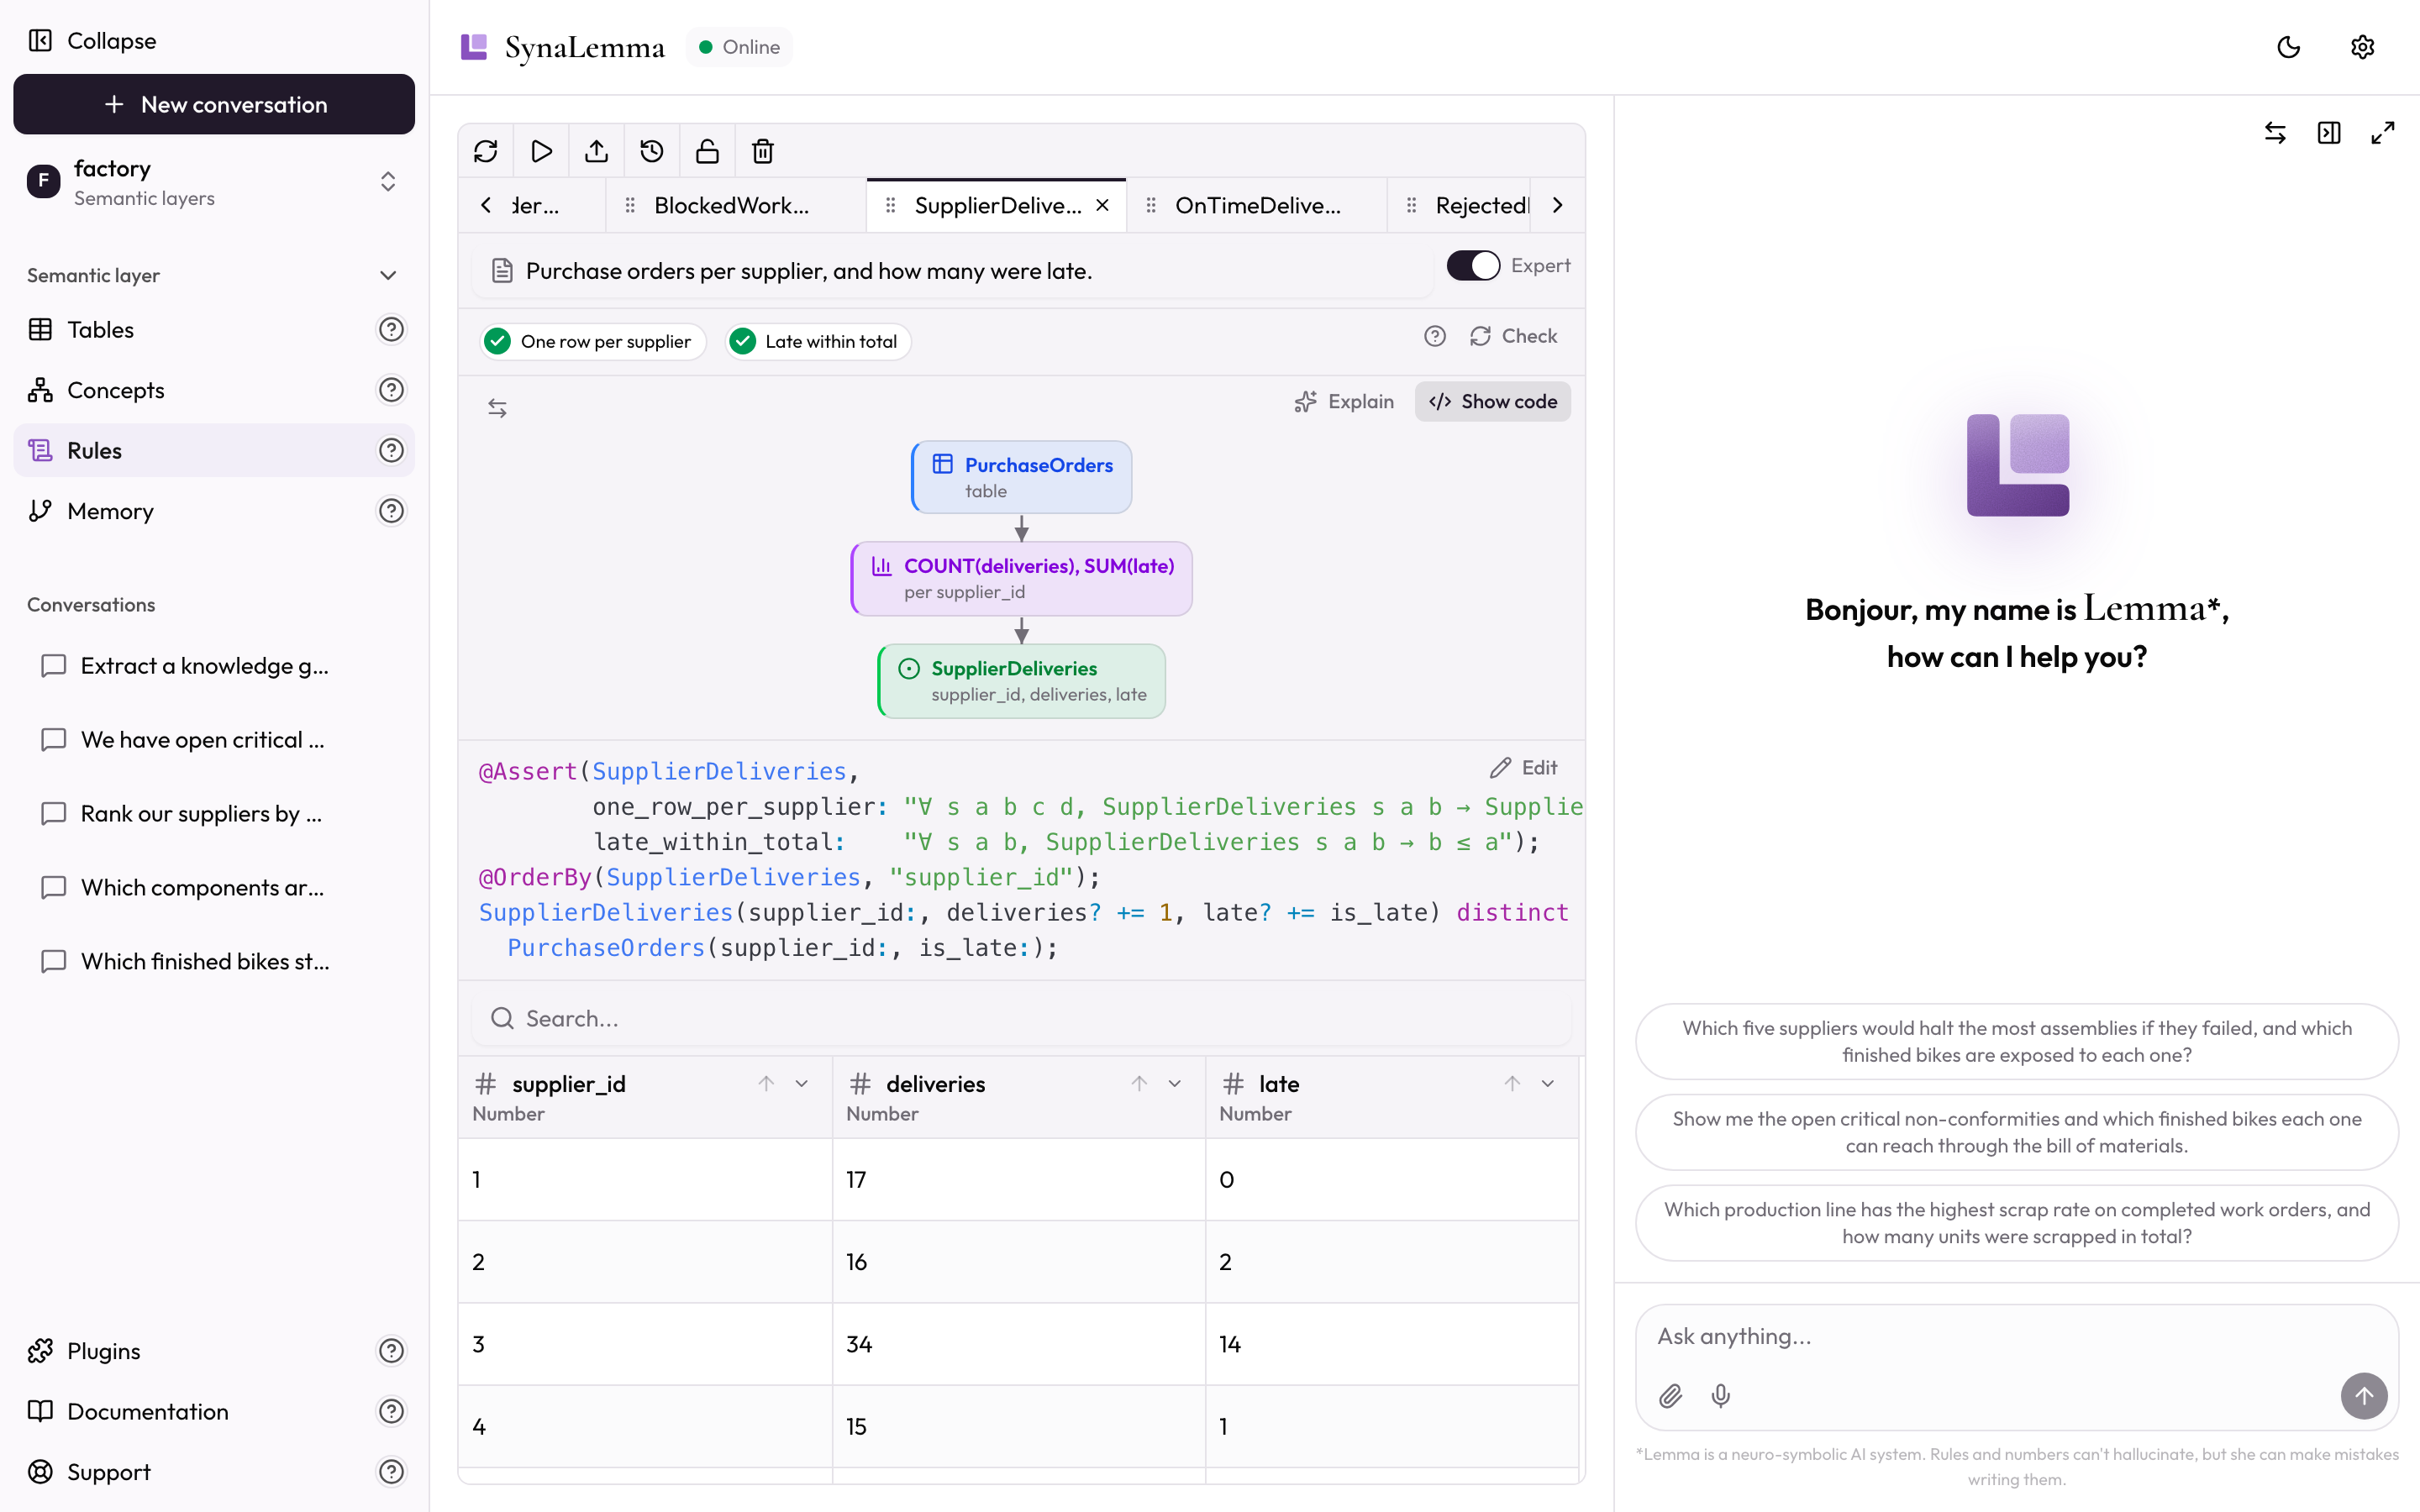
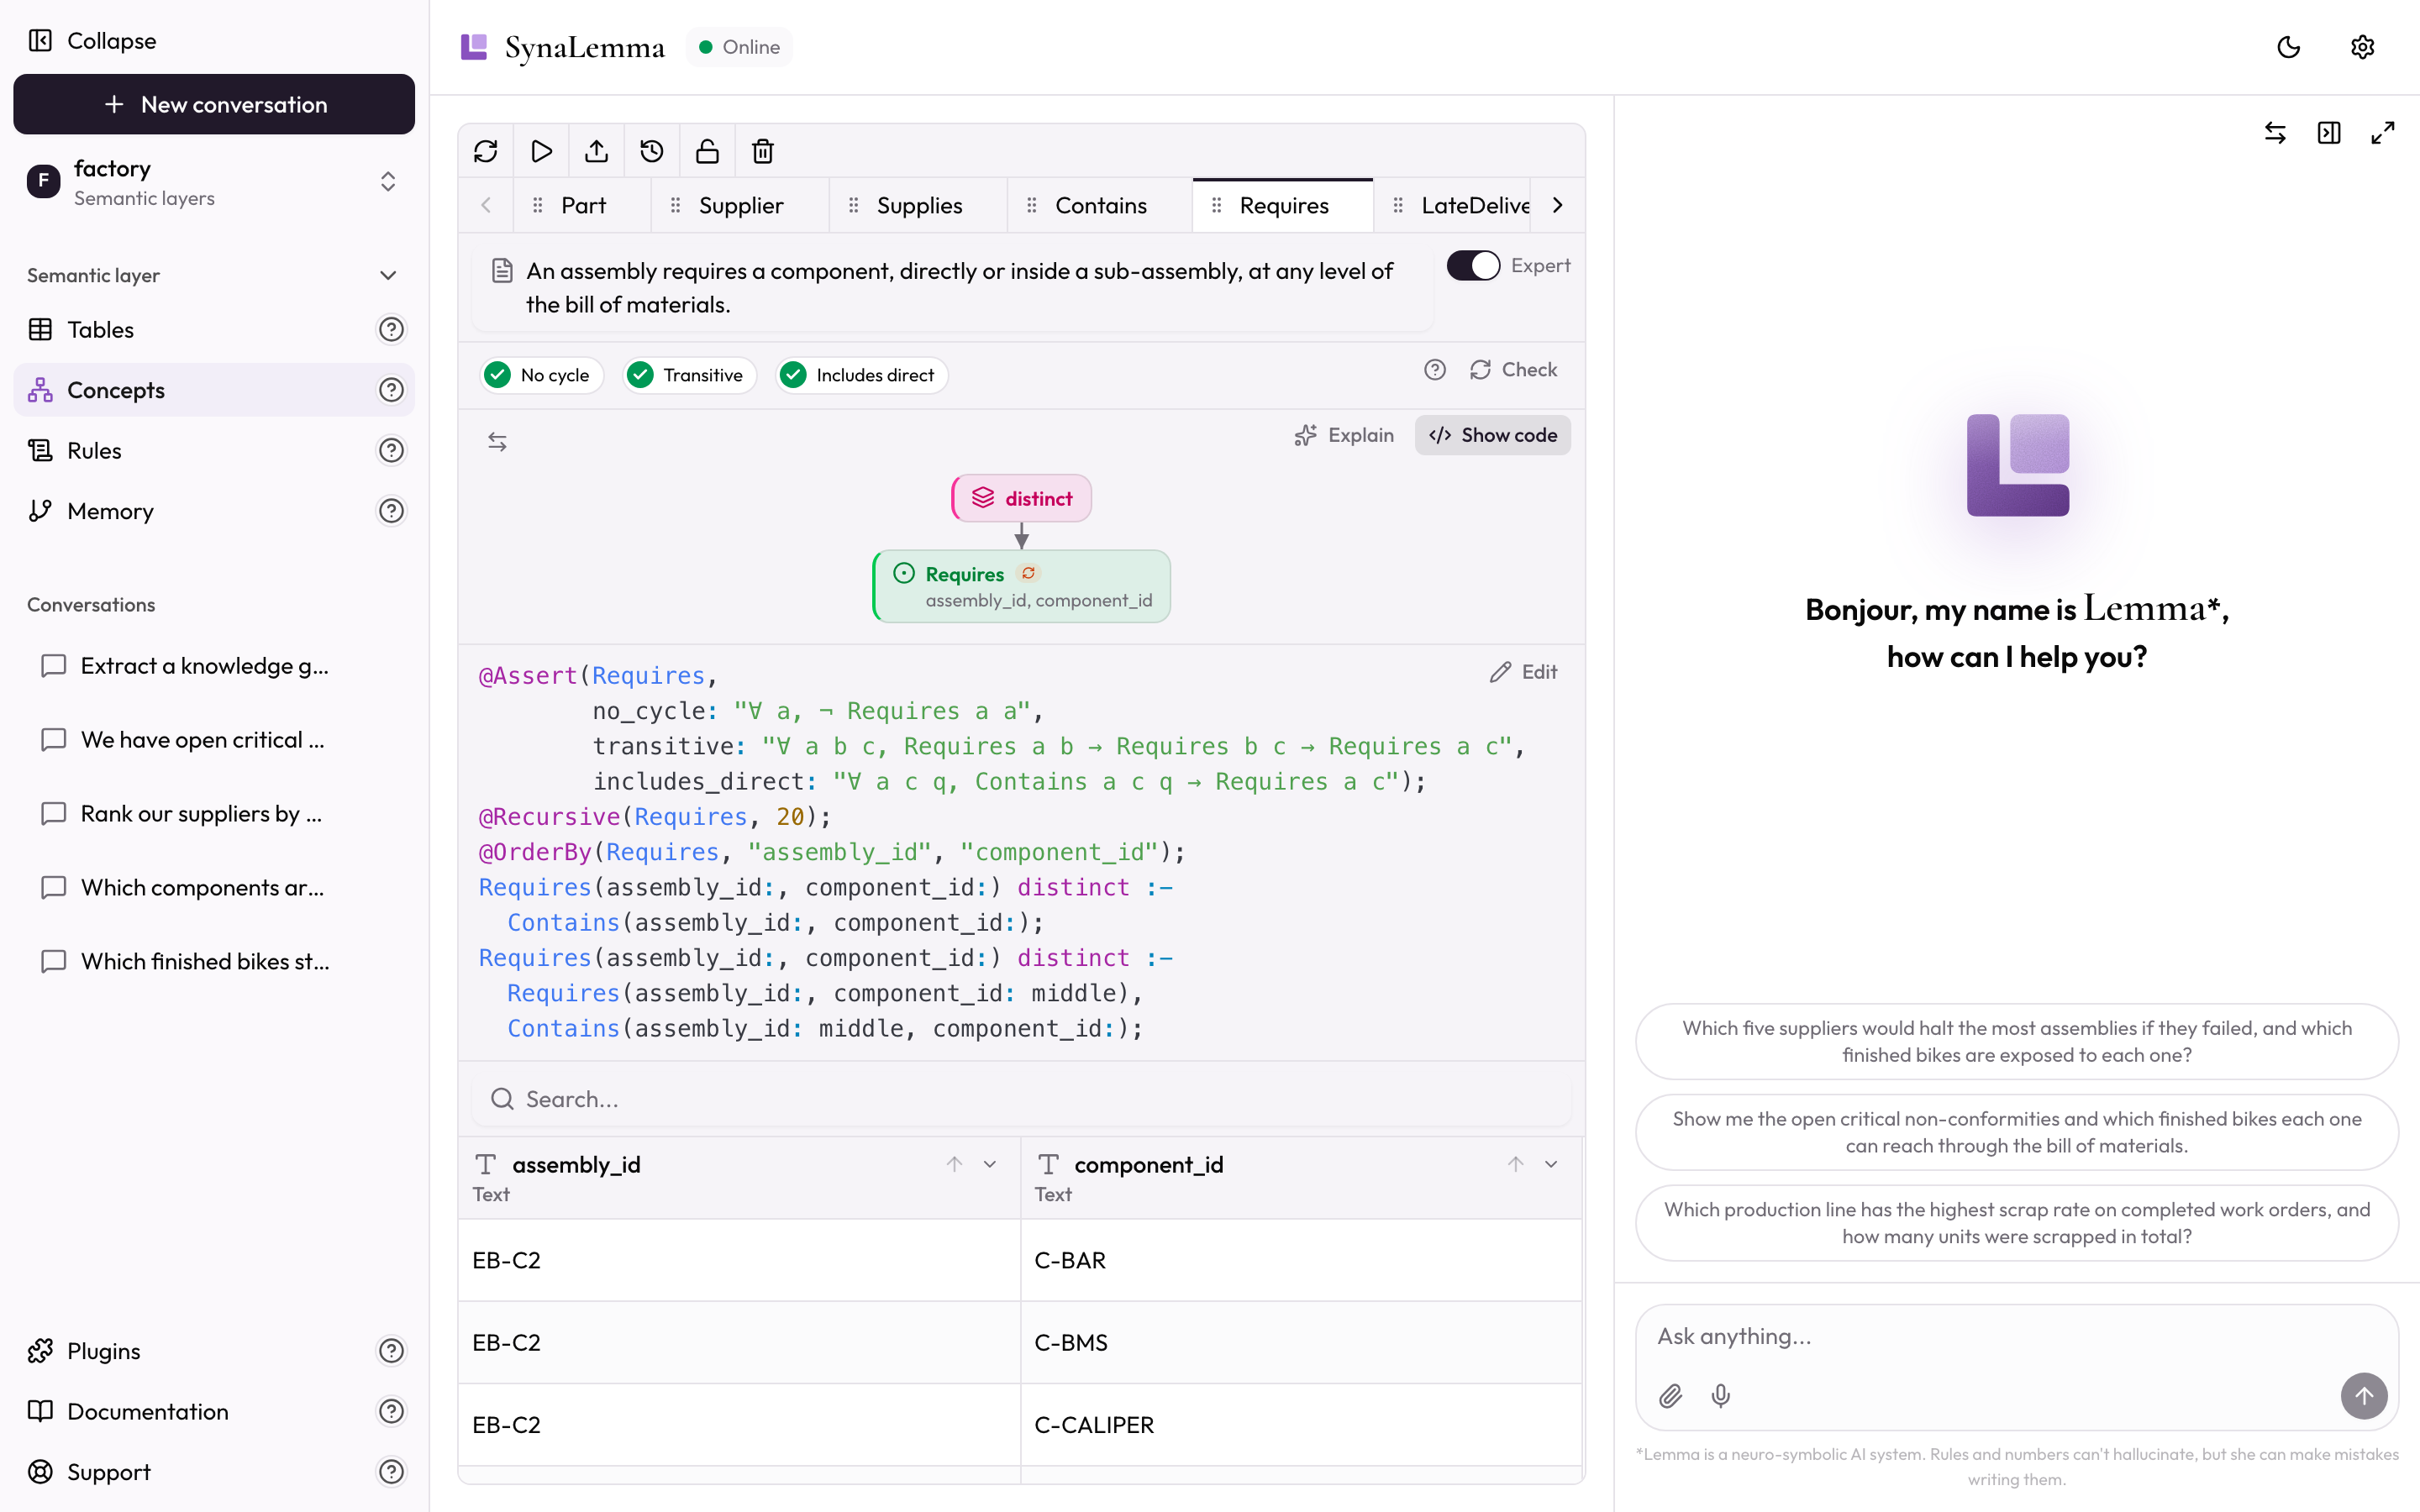
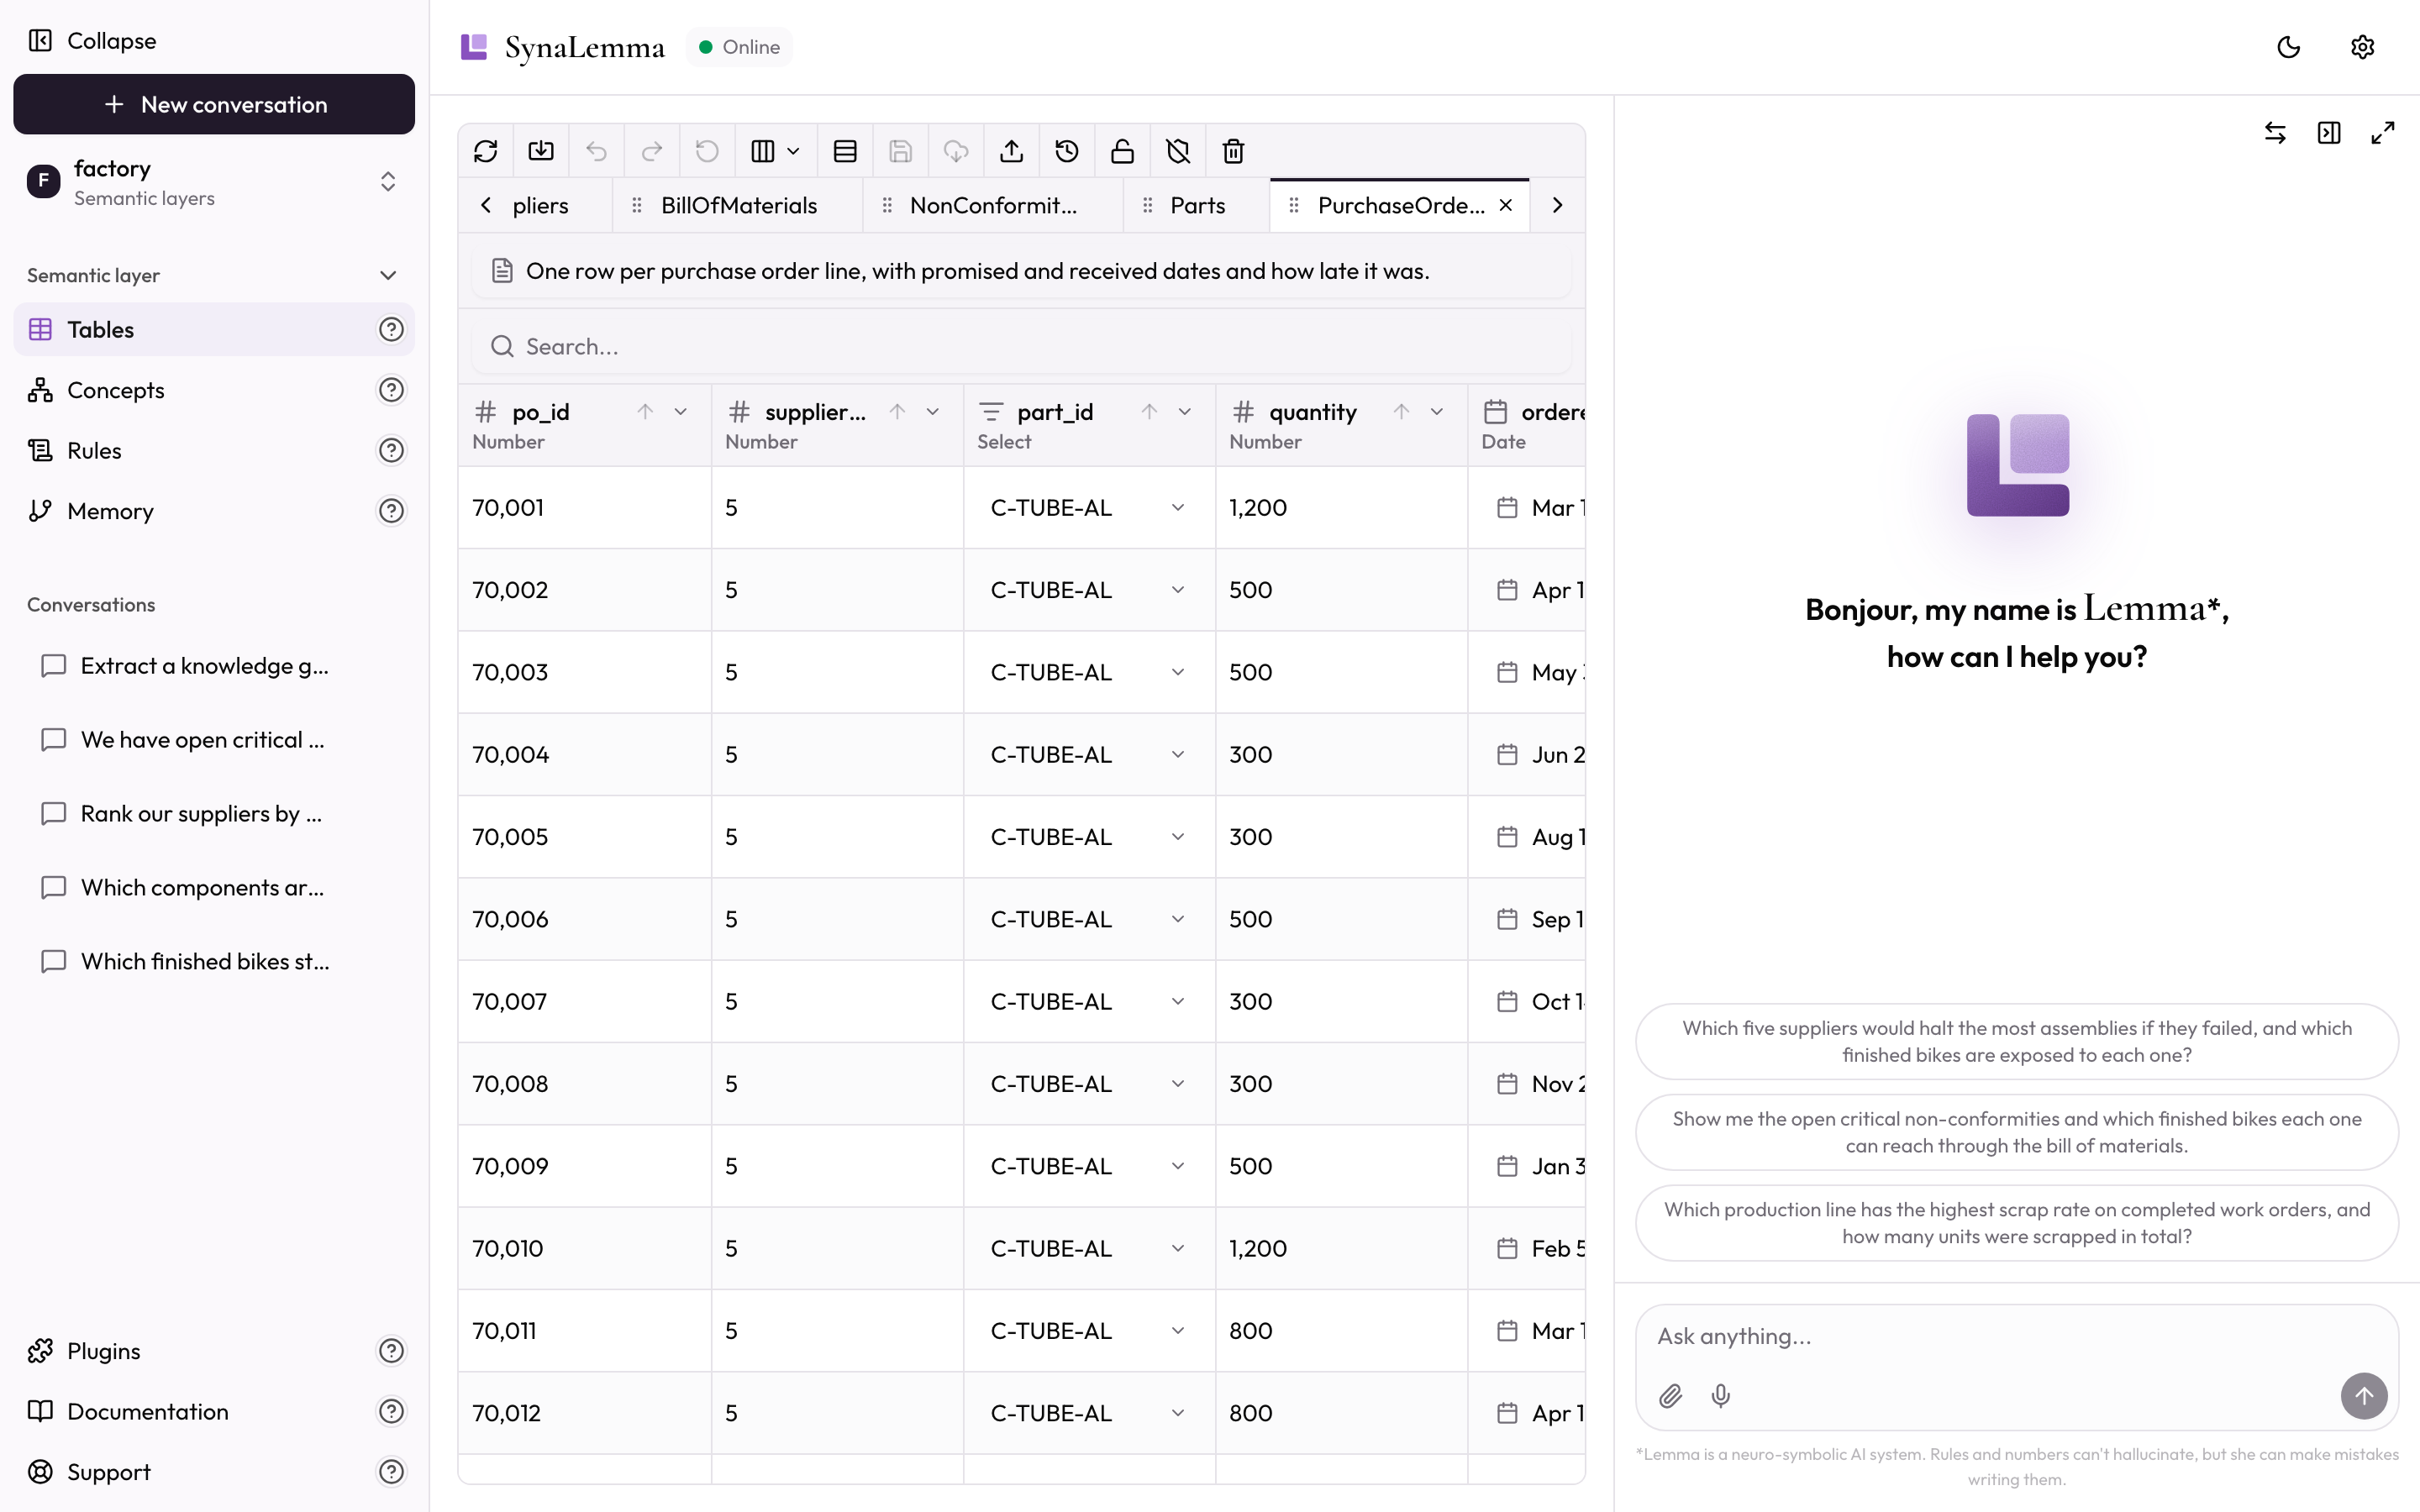
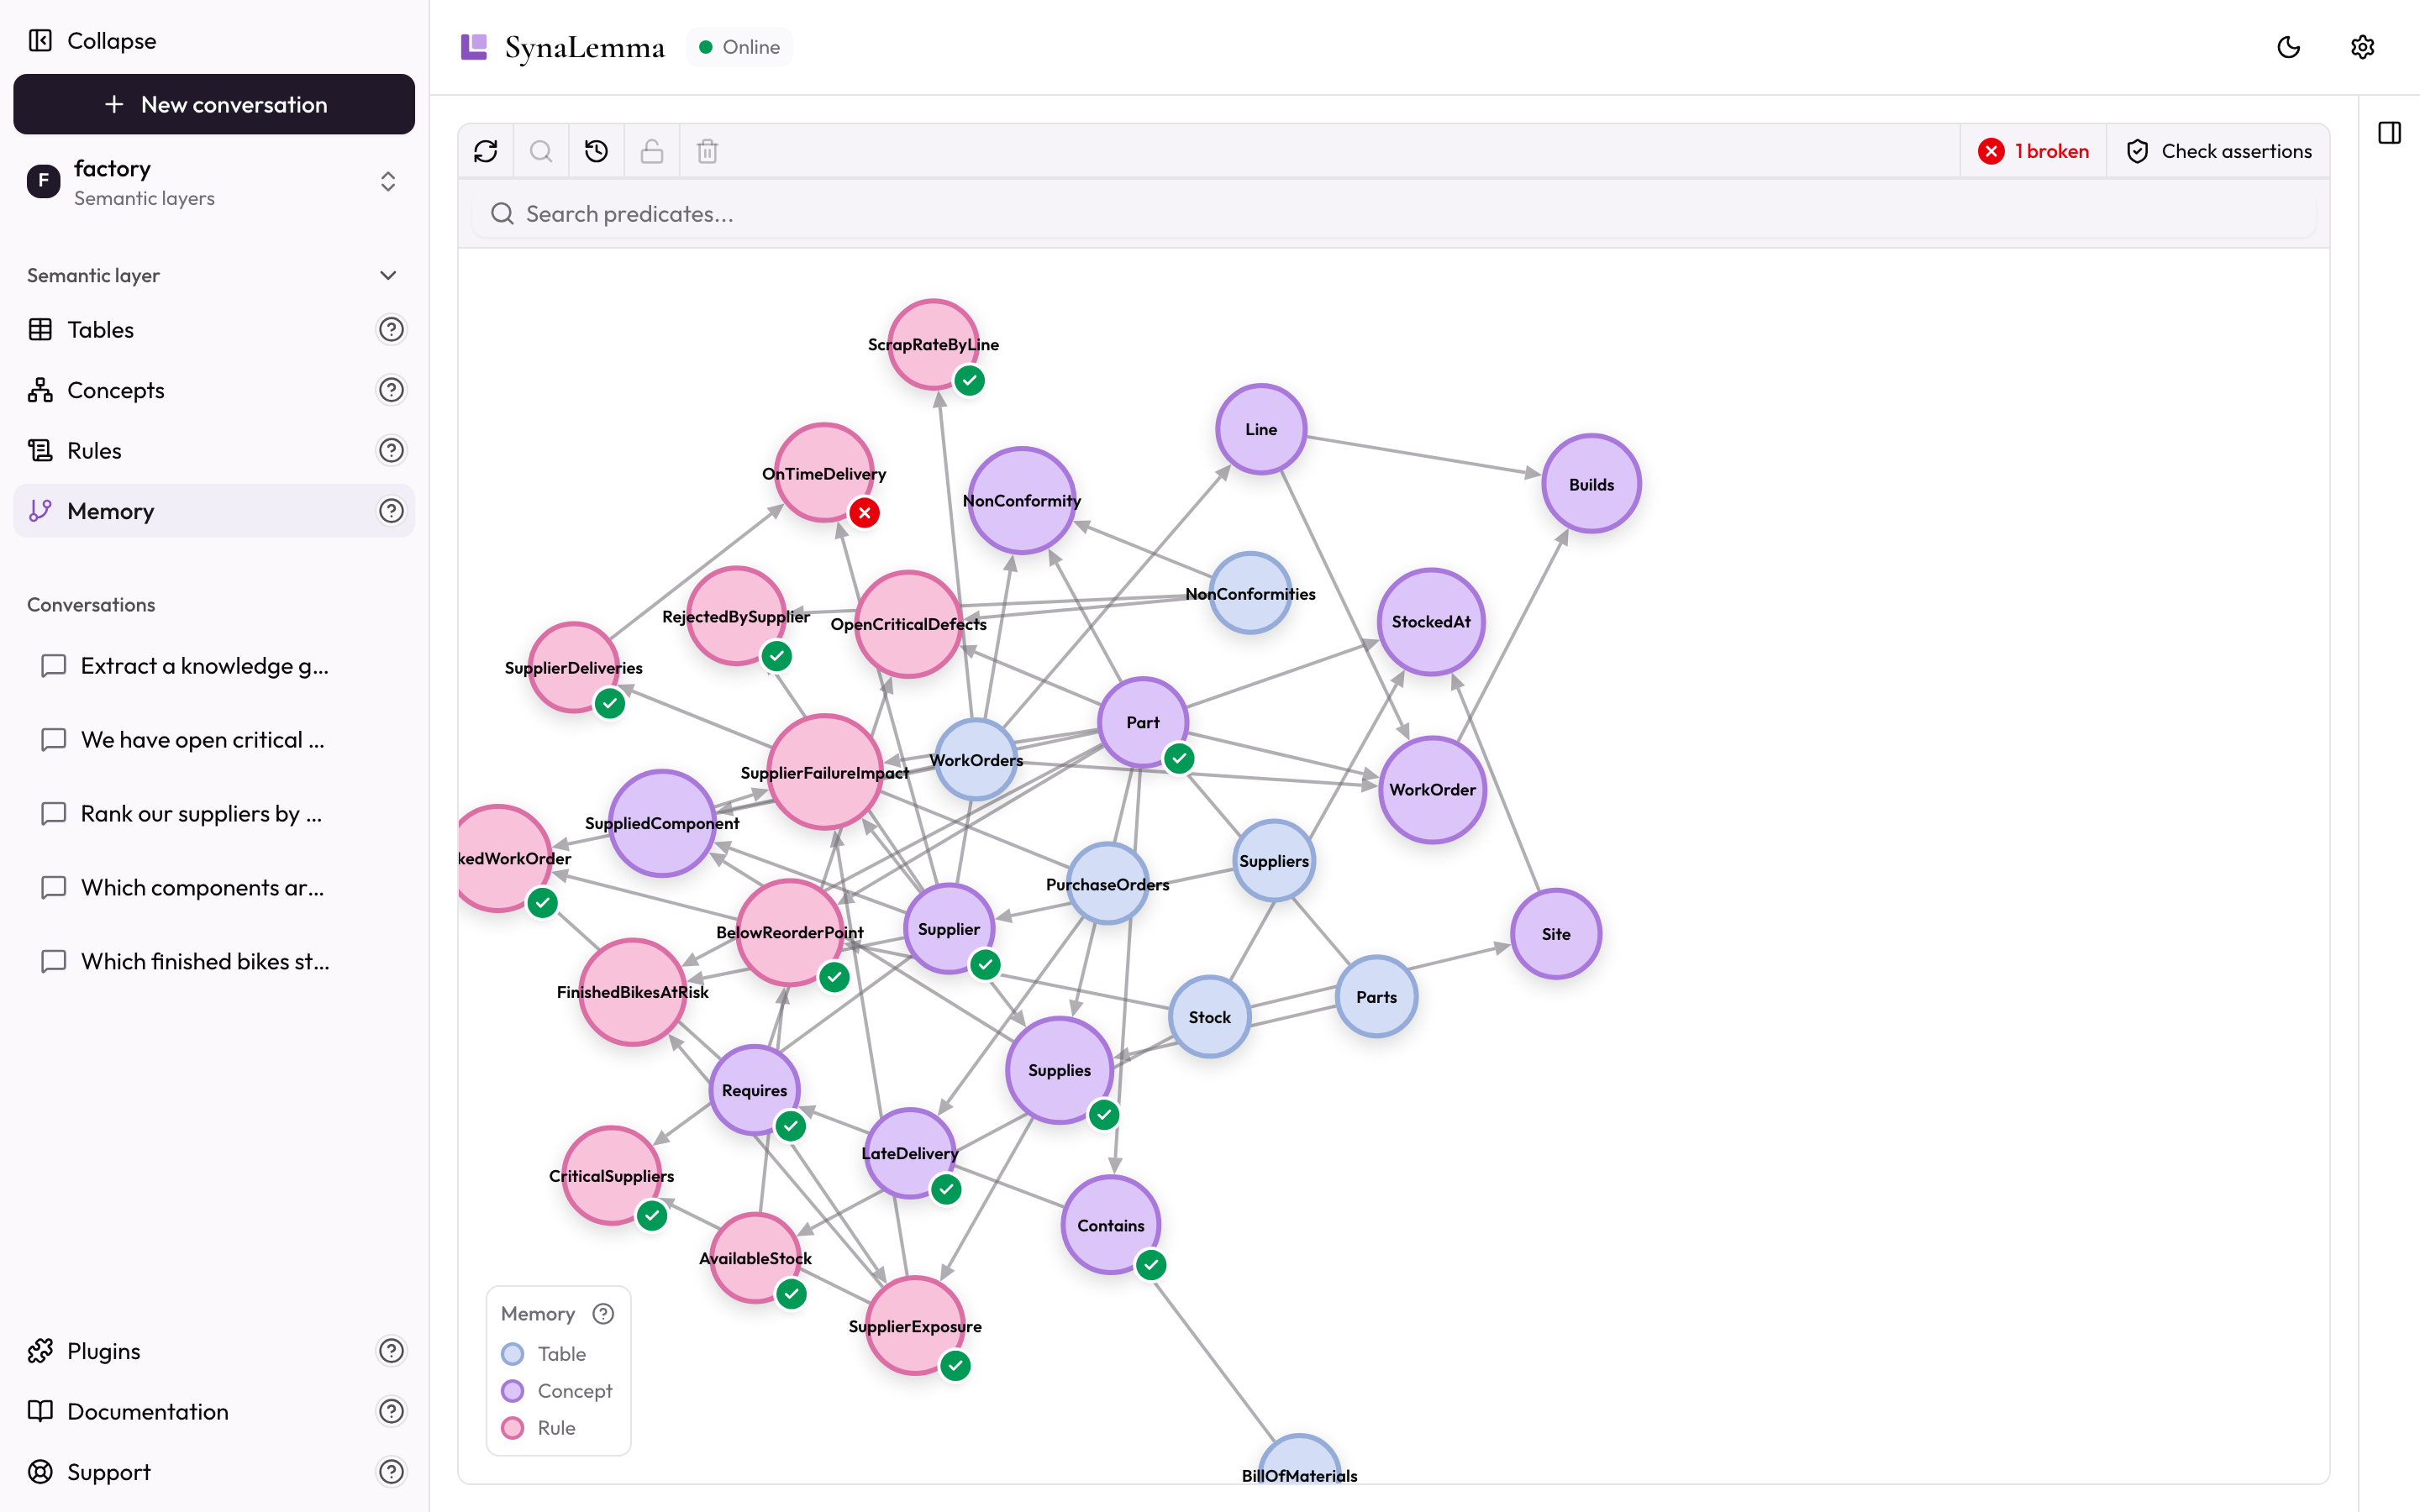
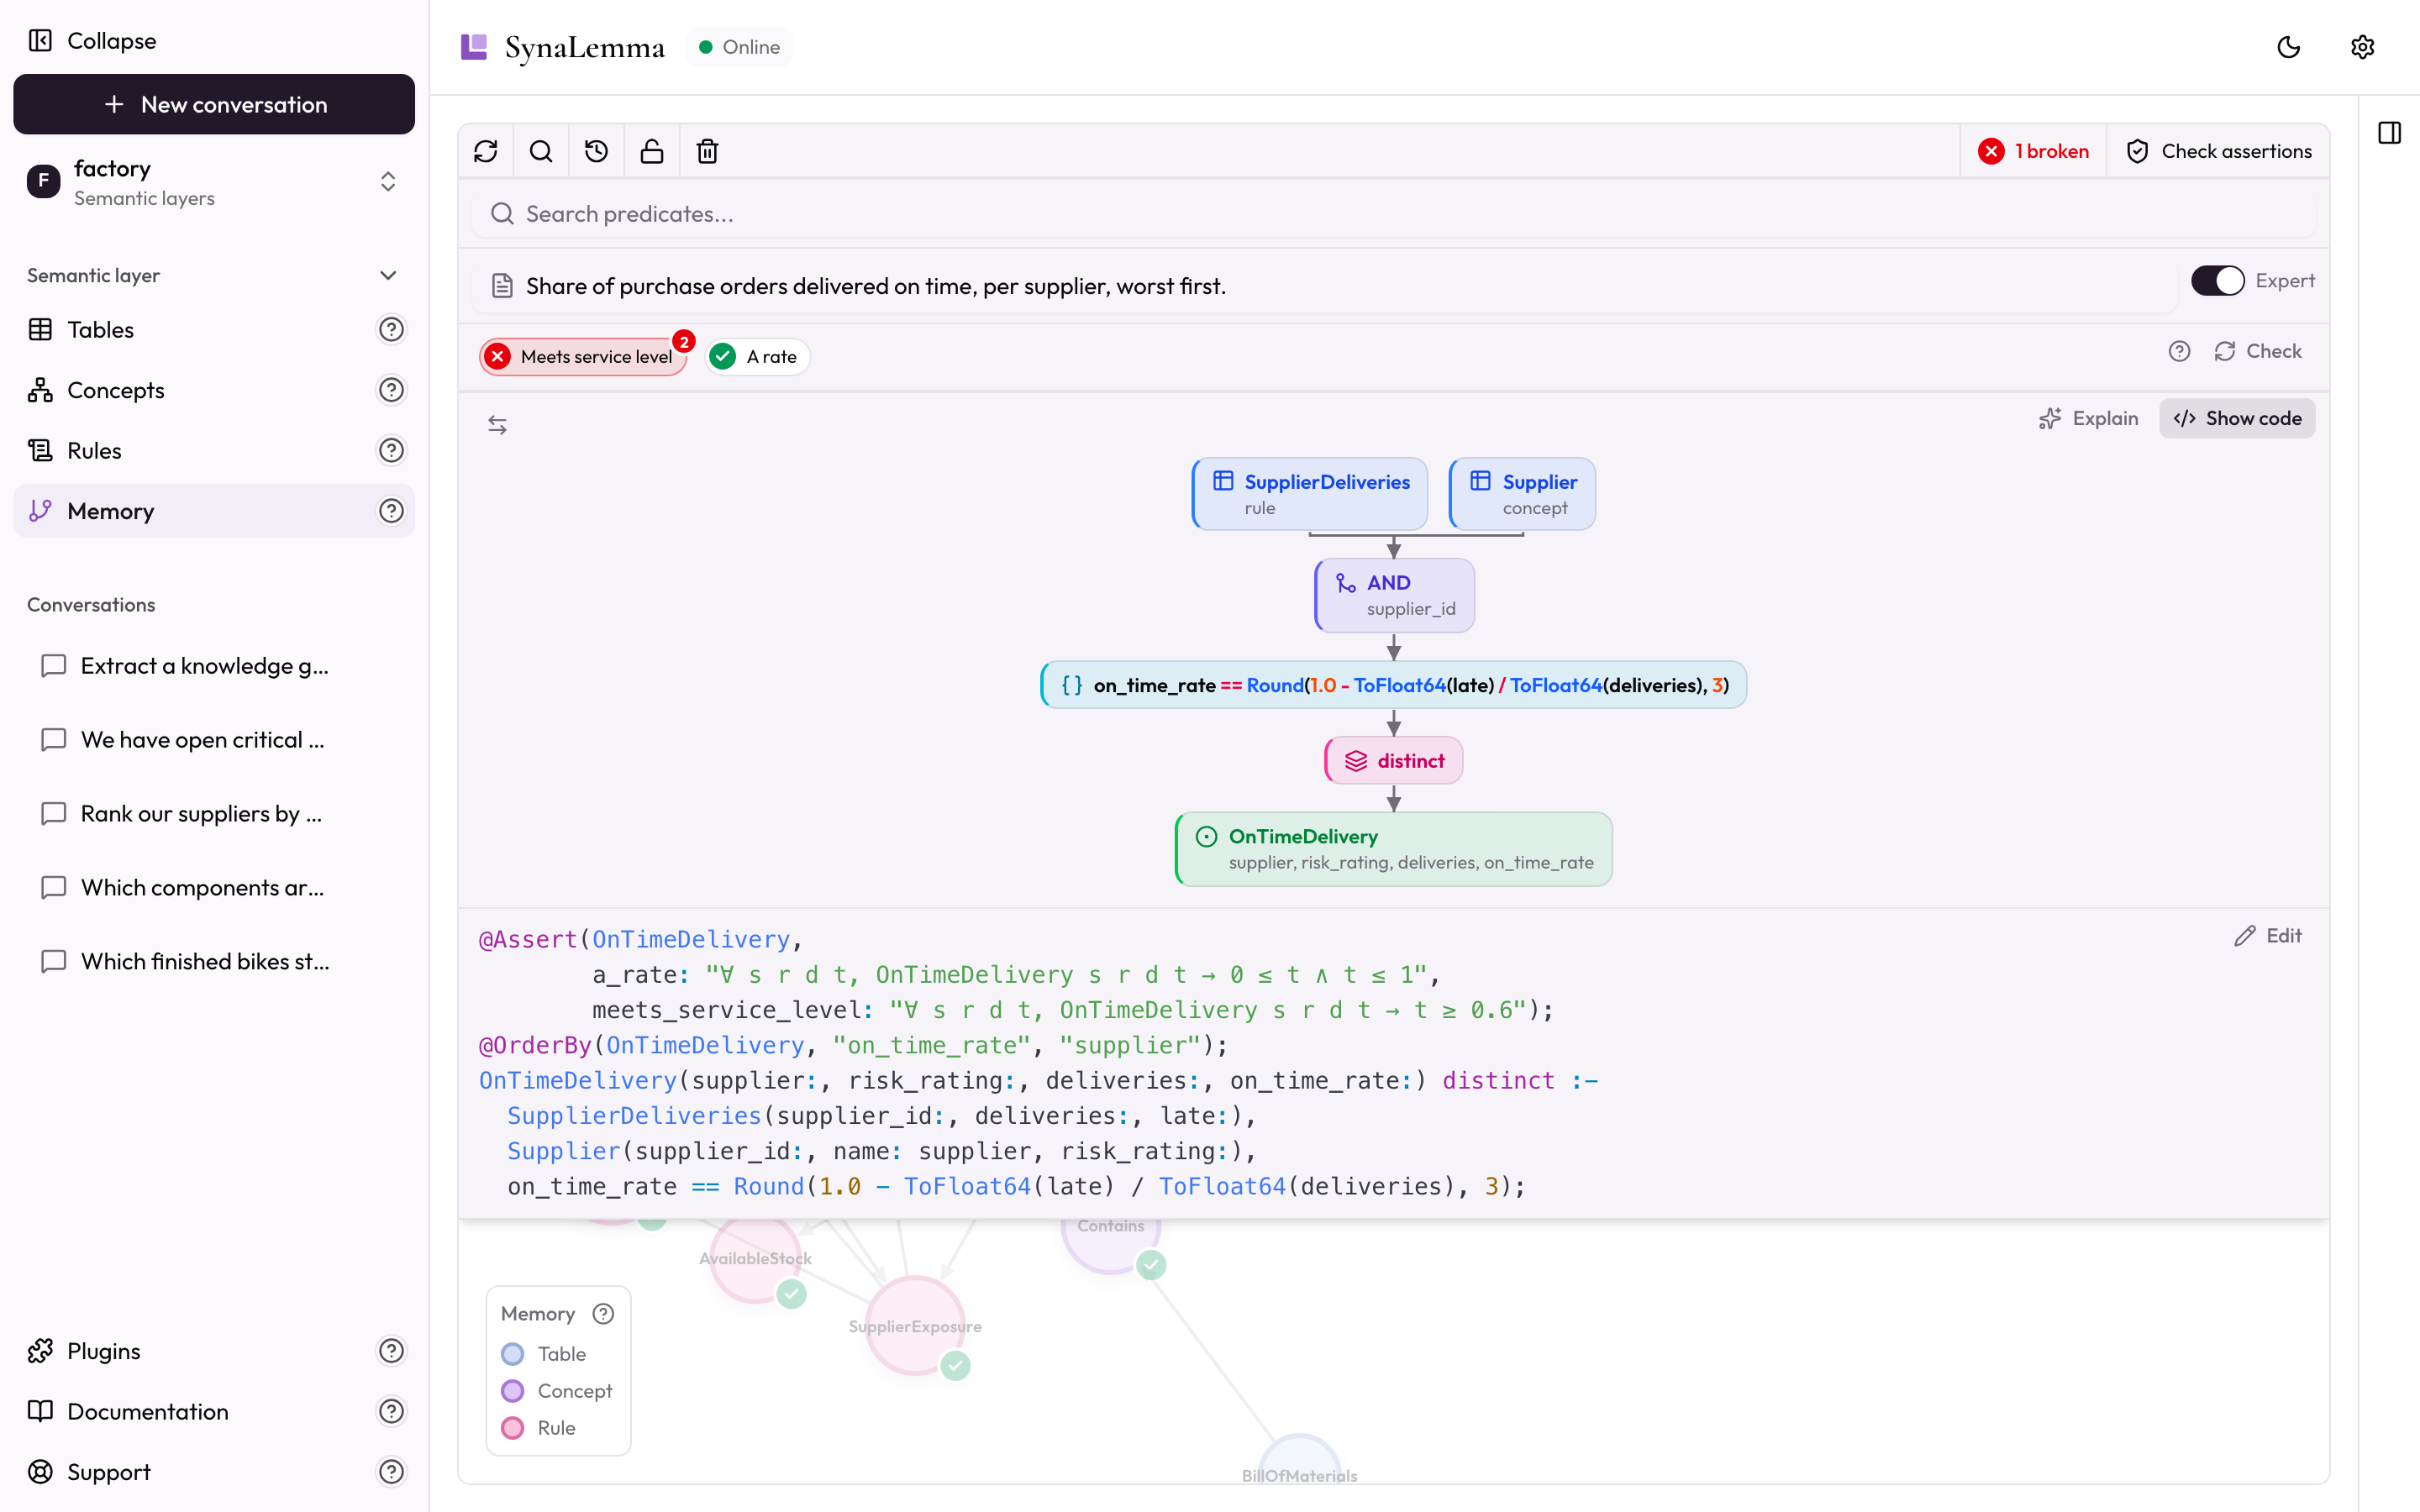
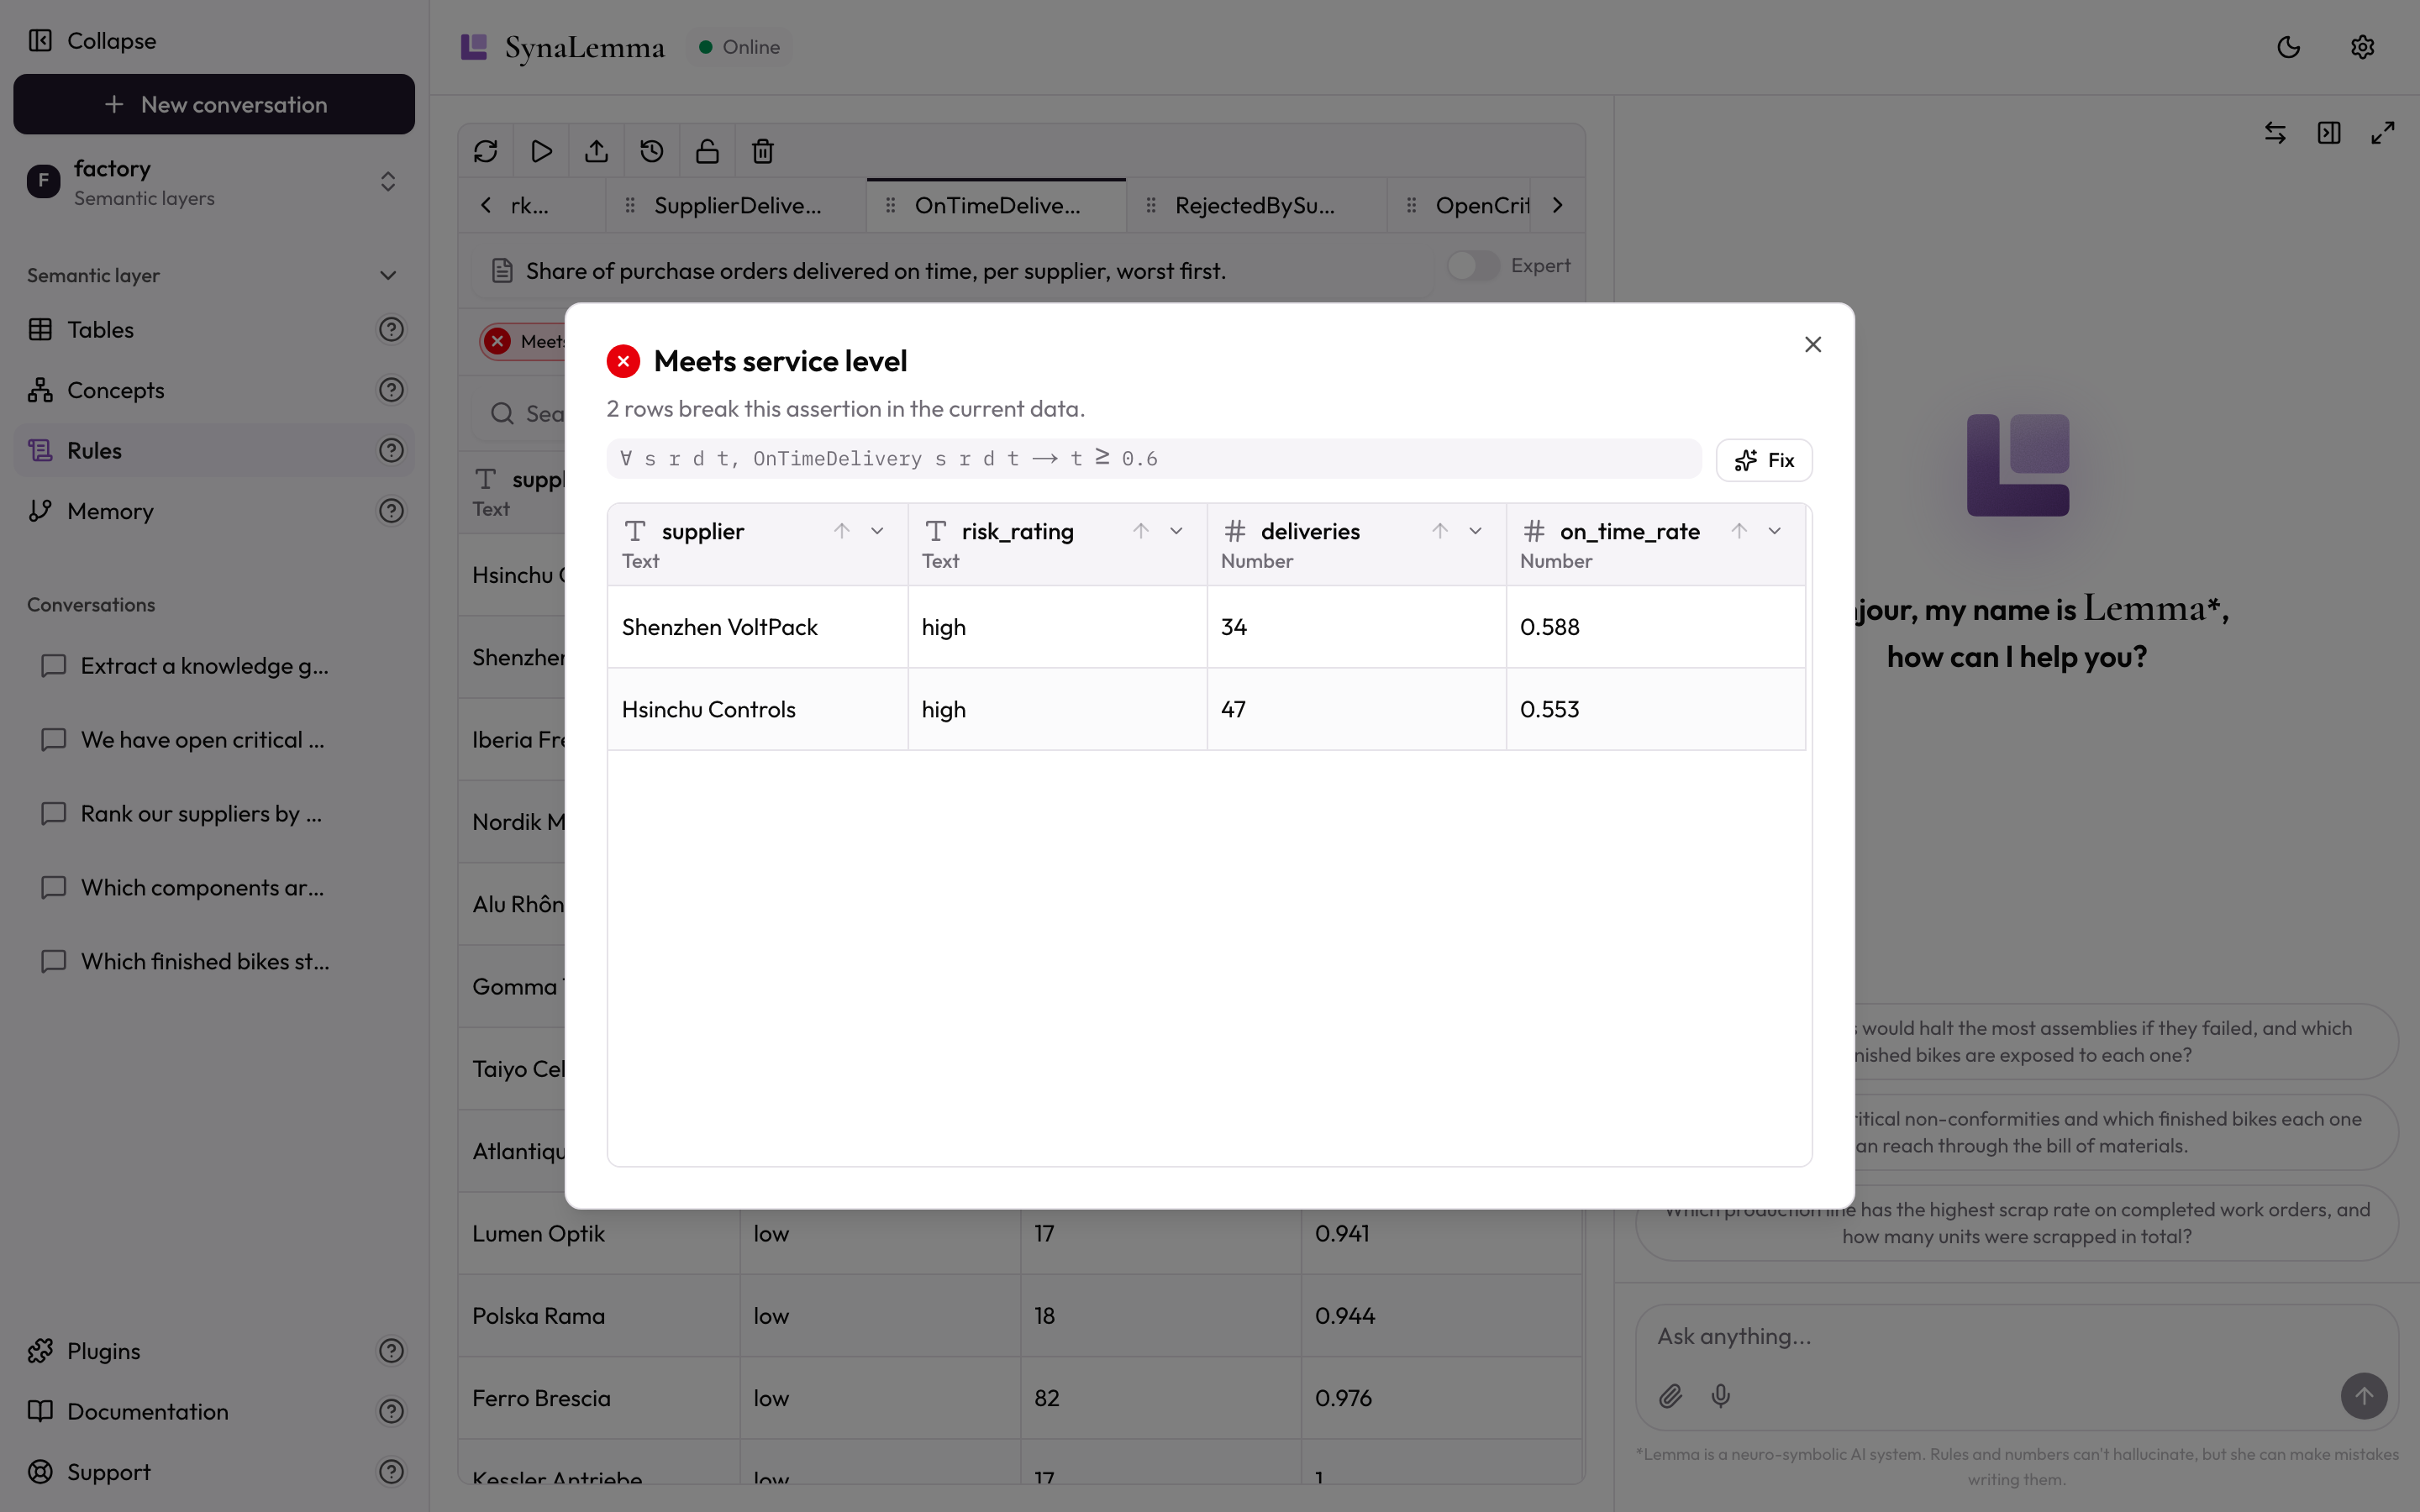
In SynaLemma, il layer è un programma Synalog: concetti e regole compilati in modo deterministico in SQL. La verifica è affidata a un sistema simbolico, non a un modello. Prima che venga eseguito qualsiasi SQL, il verificatore dimostra che ogni regola è ben formata, sicura e termina, e rifiuta ogni regola che non lo sia. Le asserzioni scritte in logica del primo ordine vengono controllate sui vostri dati, e un'asserzione violata torna con i suoi controesempi. La stessa regola compila sempre nella stessa query, e ogni risposta risale, attraverso regole con un nome, fino alle vostre tabelle.
Synalog esprime anche ciò che un elenco di frammenti SQL non può esprimere: regole costruite su altre regole, ricorsione (gerarchie, catene a più passaggi), relazioni tra concetti e ragionamento nel tempo. È questo rigore a dare senso alla verifica: un file YAML a tipizzazione debole ha troppa poca struttura perché una dimostrazione possa dire qualcosa.
Synalog è un vero linguaggio di programmazione, e richiede più impegno per impararlo di un file YAML. Non dovete scriverlo voi: l'harness di analisi di SynaLemma scrive e mantiene le regole, e il verificatore controlla il suo lavoro prima che arrivi ai vostri dati. Abbiamo ottimizzato noi stessi questo harness, con il machine learning e il nostro framework open source Synalinks, perché l'analista funzioni con modelli locali sul vostro hardware, senza costi per token. Senza un harness messo a punto in questo modo, i team ripiegano sui modelli di frontiera e pagano ogni domanda. E poiché le risposte nascono da regole compilate e non da SQL generato a ogni domanda, un modello più piccolo arriva più lontano.
Leggi il confronto completo
Come si confrontano SynaLemma e Synalog con Apache Ossie?
Risolvono problemi diversi. Ossie è un formato di file: una specifica YAML neutrale rispetto ai fornitori, in incubazione presso la Apache Software Foundation, per scambiare dataset, metriche e join tra strumenti di BI e di analisi. Non esegue query. Ogni strumento che legge un file Ossie decide come tradurlo in SQL, e l'SQL di ciascun database va scritto a mano nel file.
Synalog è un linguaggio con un compilatore. Uno stesso programma compila in SQL per PostgreSQL, BigQuery, Databricks, Trino, Presto, DuckDB e SQLite, e la stessa regola compila sempre nella stessa query.
La differenza si vede in ciò che ciascuno può esprimere. Nella specifica di base di Ossie (una specifica di ontologia in bozza aggiunge concetti derivati e relazioni ricorsive), una metrica non può fare riferimento a un'altra metrica, un campo non può fare riferimento a un altro campo, un dataset non può basarsi su un altro dataset, e ogni relazione è una chiave esterna molti-a-uno. Il tempo è solo un indicatore su una colonna. In Synalog, le regole si costruiscono su altre regole, così le definizioni si accumulano invece di ripetersi. Gestisce anche la ricorsione (gerarchie, catene a più passaggi), le relazioni tra concetti e il ragionamento nel tempo.
Si vede anche in ciò che si può verificare. Un file Ossie può essere validato rispetto al suo schema e ai suoi riferimenti. Un programma Synalog è controllato da un verificatore simbolico, che dimostra prima di eseguire qualsiasi SQL che ogni regola è ben formata, sicura e termina. Le asserzioni scritte in logica del primo ordine vengono controllate sui vostri dati, con controesempi quando falliscono. Per gli agenti, Ossie offre indicazioni in testo libero (ai_context) che un modello può leggere. L'analista di SynaLemma scrive regole Synalog, e il verificatore le controlla prima che tocchino i vostri dati.
SynaLemma serve per definizioni che devono essere calcolate, verificate ed estese da agenti, non solo scambiate tra strumenti.
Leggi il confronto completo
Come si confrontano SynaLemma e Synalog con gli strumenti del web semantico (RDF, OWL, SHACL)?
Entrambi descrivono il significato dei dati con concetti e relazioni, ed entrambi ragionano su di essi. Ma sono costruiti per compiti diversi. Il web semantico descrive un dominio perché le ontologie possano essere pubblicate, condivise e collegate tra organizzazioni. Synalog descrive ontologie operative: solo i concetti e le relazioni che i vostri dati contengono davvero, ciascuno definito a partire dalle vostre tabelle e calcolato da esse.
Questo cambia la logica. OWL lavora sotto l'ipotesi del mondo aperto: un fatto assente dal grafo è sconosciuto, non falso, quindi OWL da solo non può verificare che ogni ordine abbia un cliente. SHACL esiste per colmare questa lacuna, come secondo linguaggio che valida i dati. Synalog è a mondo chiuso, come il vostro database: ciò che non è nei dati è falso. Regole, query e vincoli si scrivono in un unico linguaggio, e le asserzioni controllano direttamente i vostri dati, con controesempi quando falliscono.
Cambia anche lo stack. Un'implementazione del web semantico combina di solito RDF per i dati, OWL per l'ontologia, SHACL per la validazione e SPARQL per le query, più un triplestore o un linguaggio di mappatura come R2RML per raggiungere le tabelle relazionali. Synalog è un unico linguaggio che compila in SQL e gira sui database che avete già.
Più semplice non vuol dire meno ragionamento. Uno stesso programma Synalog può combinare ricorsione, aggregazione, negazione e ragionamento nel tempo, e un verificatore simbolico dimostra, prima dell'esecuzione, che ogni regola è ben formata, sicura e termina. I reasoner OWL classificano concetti; non calcolano i totali, le medie e le classifiche di cui ha bisogno la maggior parte delle domande di business.
Synalog è anche costruito per gli agenti. I suoi programmi sono abbastanza brevi perché un modello li scriva e abbastanza leggibili perché una persona li rilegga, e l'analista di SynaLemma li scrive man mano che arrivano le domande, ciascuno controllato dal verificatore prima che tocchi i vostri dati. Le ontologie del web semantico vengono di solito modellate in anticipo, da specialisti: un progetto che richiede comunemente mesi, spesso anni, e un budget consistente prima di rispondere alla prima domanda. Con SynaLemma, il layer si costruisce fin dalla prima domanda.
SynaLemma risponde alle domande sui vostri dati, con risposte che potete verificare, senza un progetto di modellazione preliminare.
Leggi il confronto completo
Come si confrontano SynaLemma e Synalog con Cube?
Cube è un layer semantico e un'API, in YAML o JavaScript: cubi, viste, misure, dimensioni e join, con cache e pre-aggregazioni su molti database. Come Synalog, compila le query a partire dal suo modello prima che raggiungano il data warehouse, quindi la differenza non sta lì. Sta in ciò che il modello può esprimere, e in ciò che lo verifica.
In Cube, ogni join è un LEFT JOIN, e le gerarchie sono livelli di esplorazione, non ricorsione. Catene gerarchiche, distinte base o dipendenze su più passaggi non trovano posto nel modello: richiedono una query SQL ricorsiva scritta a mano, così difficile da scrivere correttamente che quasi nessuno la scrive. In Synalog, l'attraversamento dei grafi fa parte del linguaggio: un caso base e un passo ricorsivo, con terminazione verificata, che girano su ogni motore.
Cube verifica che un modello compili, e la sua stessa documentazione avverte che un modello che compila può comunque restituire risultati sbagliati. Le risposte del suo agente sono misurate con valutazioni rispetto a query di riferimento. Synalog dimostra che ogni regola è ben formata, sicura e termina, e controlla i dati con asserzioni scritte in logica, con controesempi quando falliscono.
L'agente di IA di Cube fa parte di Cube Cloud e scrive Cube SQL a partire dalla vostra domanda, con modelli ospitati per impostazione predefinita; usare un vostro modello è un'opzione del piano Enterprise. L'analista di SynaLemma funziona con un piccolo modello aperto, sulla vostra infrastruttura.
SynaLemma è pensato per le domande a cui un'API con cache per dashboard non sa rispondere: quelle che richiedono ragionamento, con risposte che potete verificare.
Leggi il confronto completo
Come si confrontano SynaLemma e Synalog con il dbt Semantic Layer?
Il dbt Semantic Layer, basato su MetricFlow, definisce metriche in YAML sopra i modelli dbt e compila in SQL le query sulle metriche. Le differenze stanno nell'espressività, nei controlli e in ciò che un agente può raggiungere.
MetricFlow offre un catalogo fisso di tipi di metriche (semplice, rapporto, derivata, cumulativa, conversione), senza aggregazioni personalizzate, e join di al massimo due passaggi. Non c'è ricorsione. In Synalog, le regole si costruiscono su altre regole senza un catalogo imposto, i join arrivano fin dove la domanda richiede, e l'attraversamento dei grafi fa parte del linguaggio, con terminazione verificata.
dbt verifica che la configurazione semantica sia coerente e che l'SQL generato venga eseguito, e i test dbt possono controllare le tabelle: chiavi, valori nulli e riferimenti. Synalog dimostra che ogni regola è ben formata, sicura e termina prima di eseguirla, e le sue asserzioni, scritte in logica con una notazione diversa da quella delle regole, si applicano a qualsiasi regola, comprese quelle ricorsive e derivate: transitività, totali, periodi di validità.
Il server MCP di dbt offre agli agenti query sulle metriche governate, ma anche text-to-SQL e un'esecuzione SQL che non blocca le istruzioni di scrittura. L'analista di SynaLemma ha un solo percorso verso i vostri dati: il layer verificato, e basta un account in sola lettura. Le API del Semantic Layer richiedono inoltre un piano a pagamento della piattaforma dbt; SynaLemma gira sulla vostra infrastruttura con un piccolo modello aperto.
SynaLemma va oltre la consultazione delle metriche: ragiona sui vostri dati, con risposte che potete verificare.
Leggi il confronto completo