Hoe verhouden SynaLemma en Synalog zich tot NVIDIA Auto-Ontology?
Beide plaatsen een semantische layer tussen AI-agents en uw databases. Ze verschillen in wat die layer is en in wat hem controleert.
In Auto-Ontology is de layer een woordenlijst van termen, kolomkoppelingen en SQL-fragmenten die in een database zijn opgeslagen. Op het moment van de vraag wordt hij opgehaald en als richtlijn aan een taalmodel gegeven, en het model schrijft voor elk antwoord nieuwe SQL. Een tweede aanroep van het model beoordeelt daarna of die SQL klopt. Een probabilistisch systeem dat een ander controleert, biedt geen garantie: beide kunnen op dezelfde manier fout zitten.
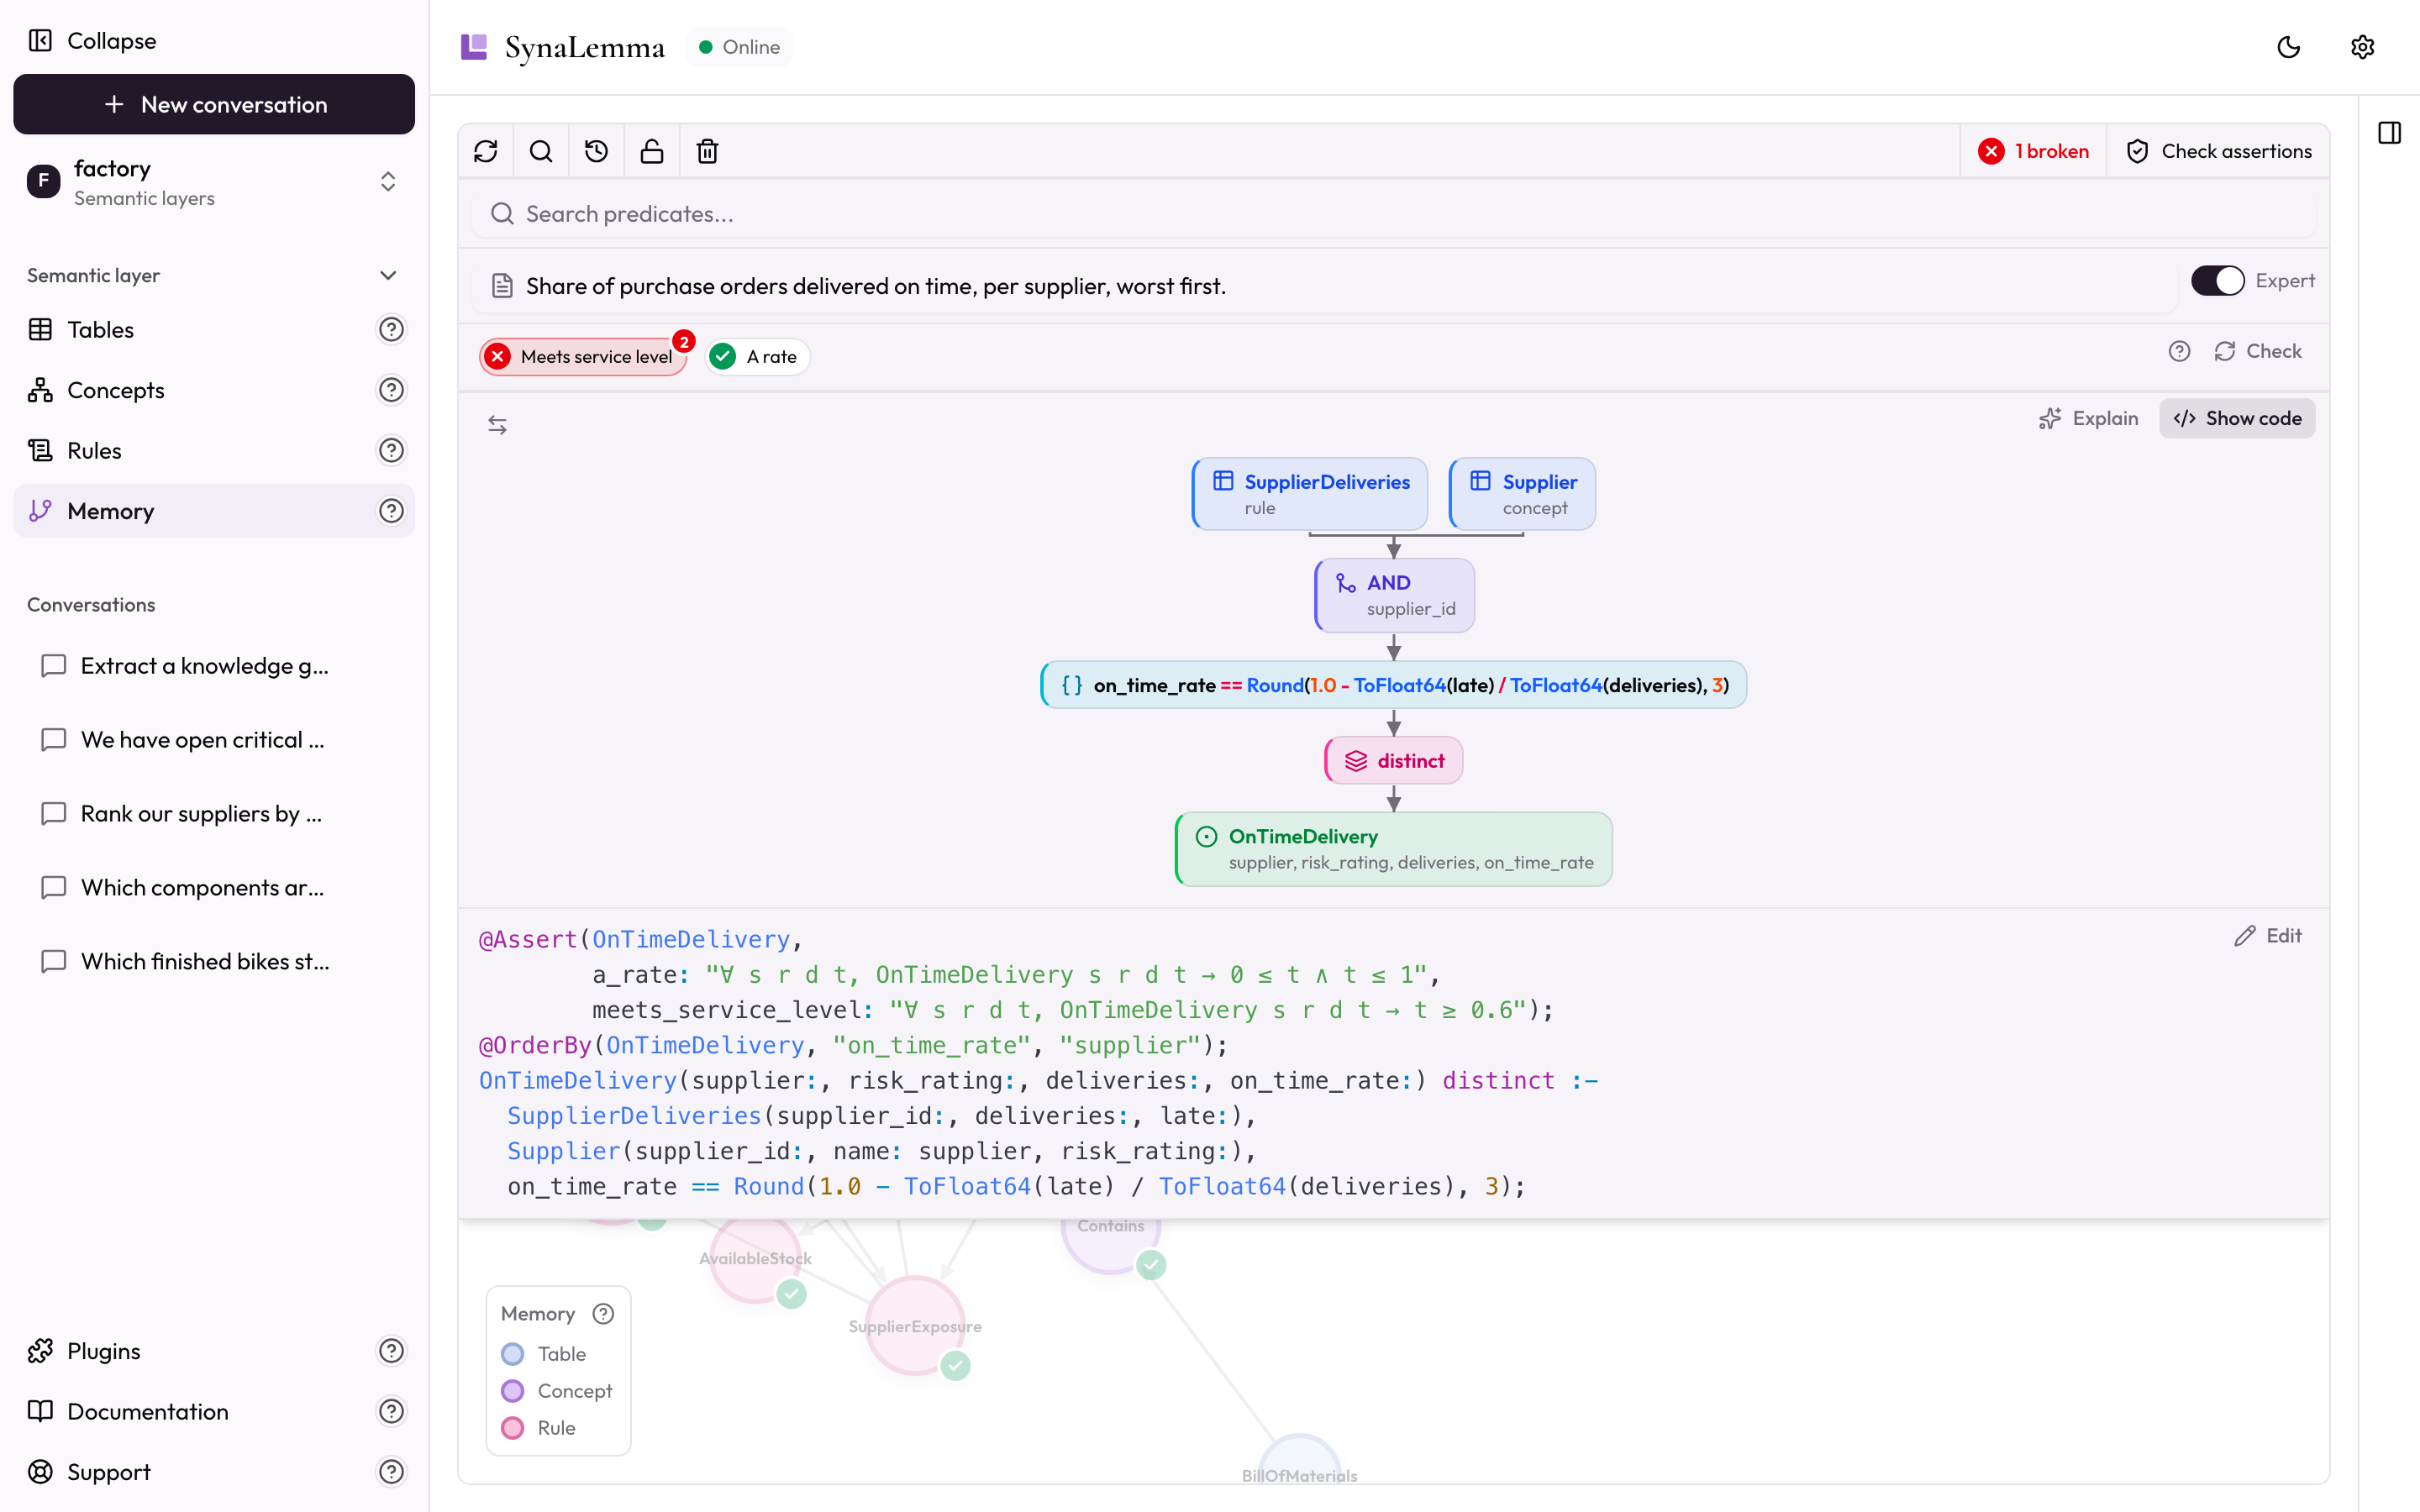
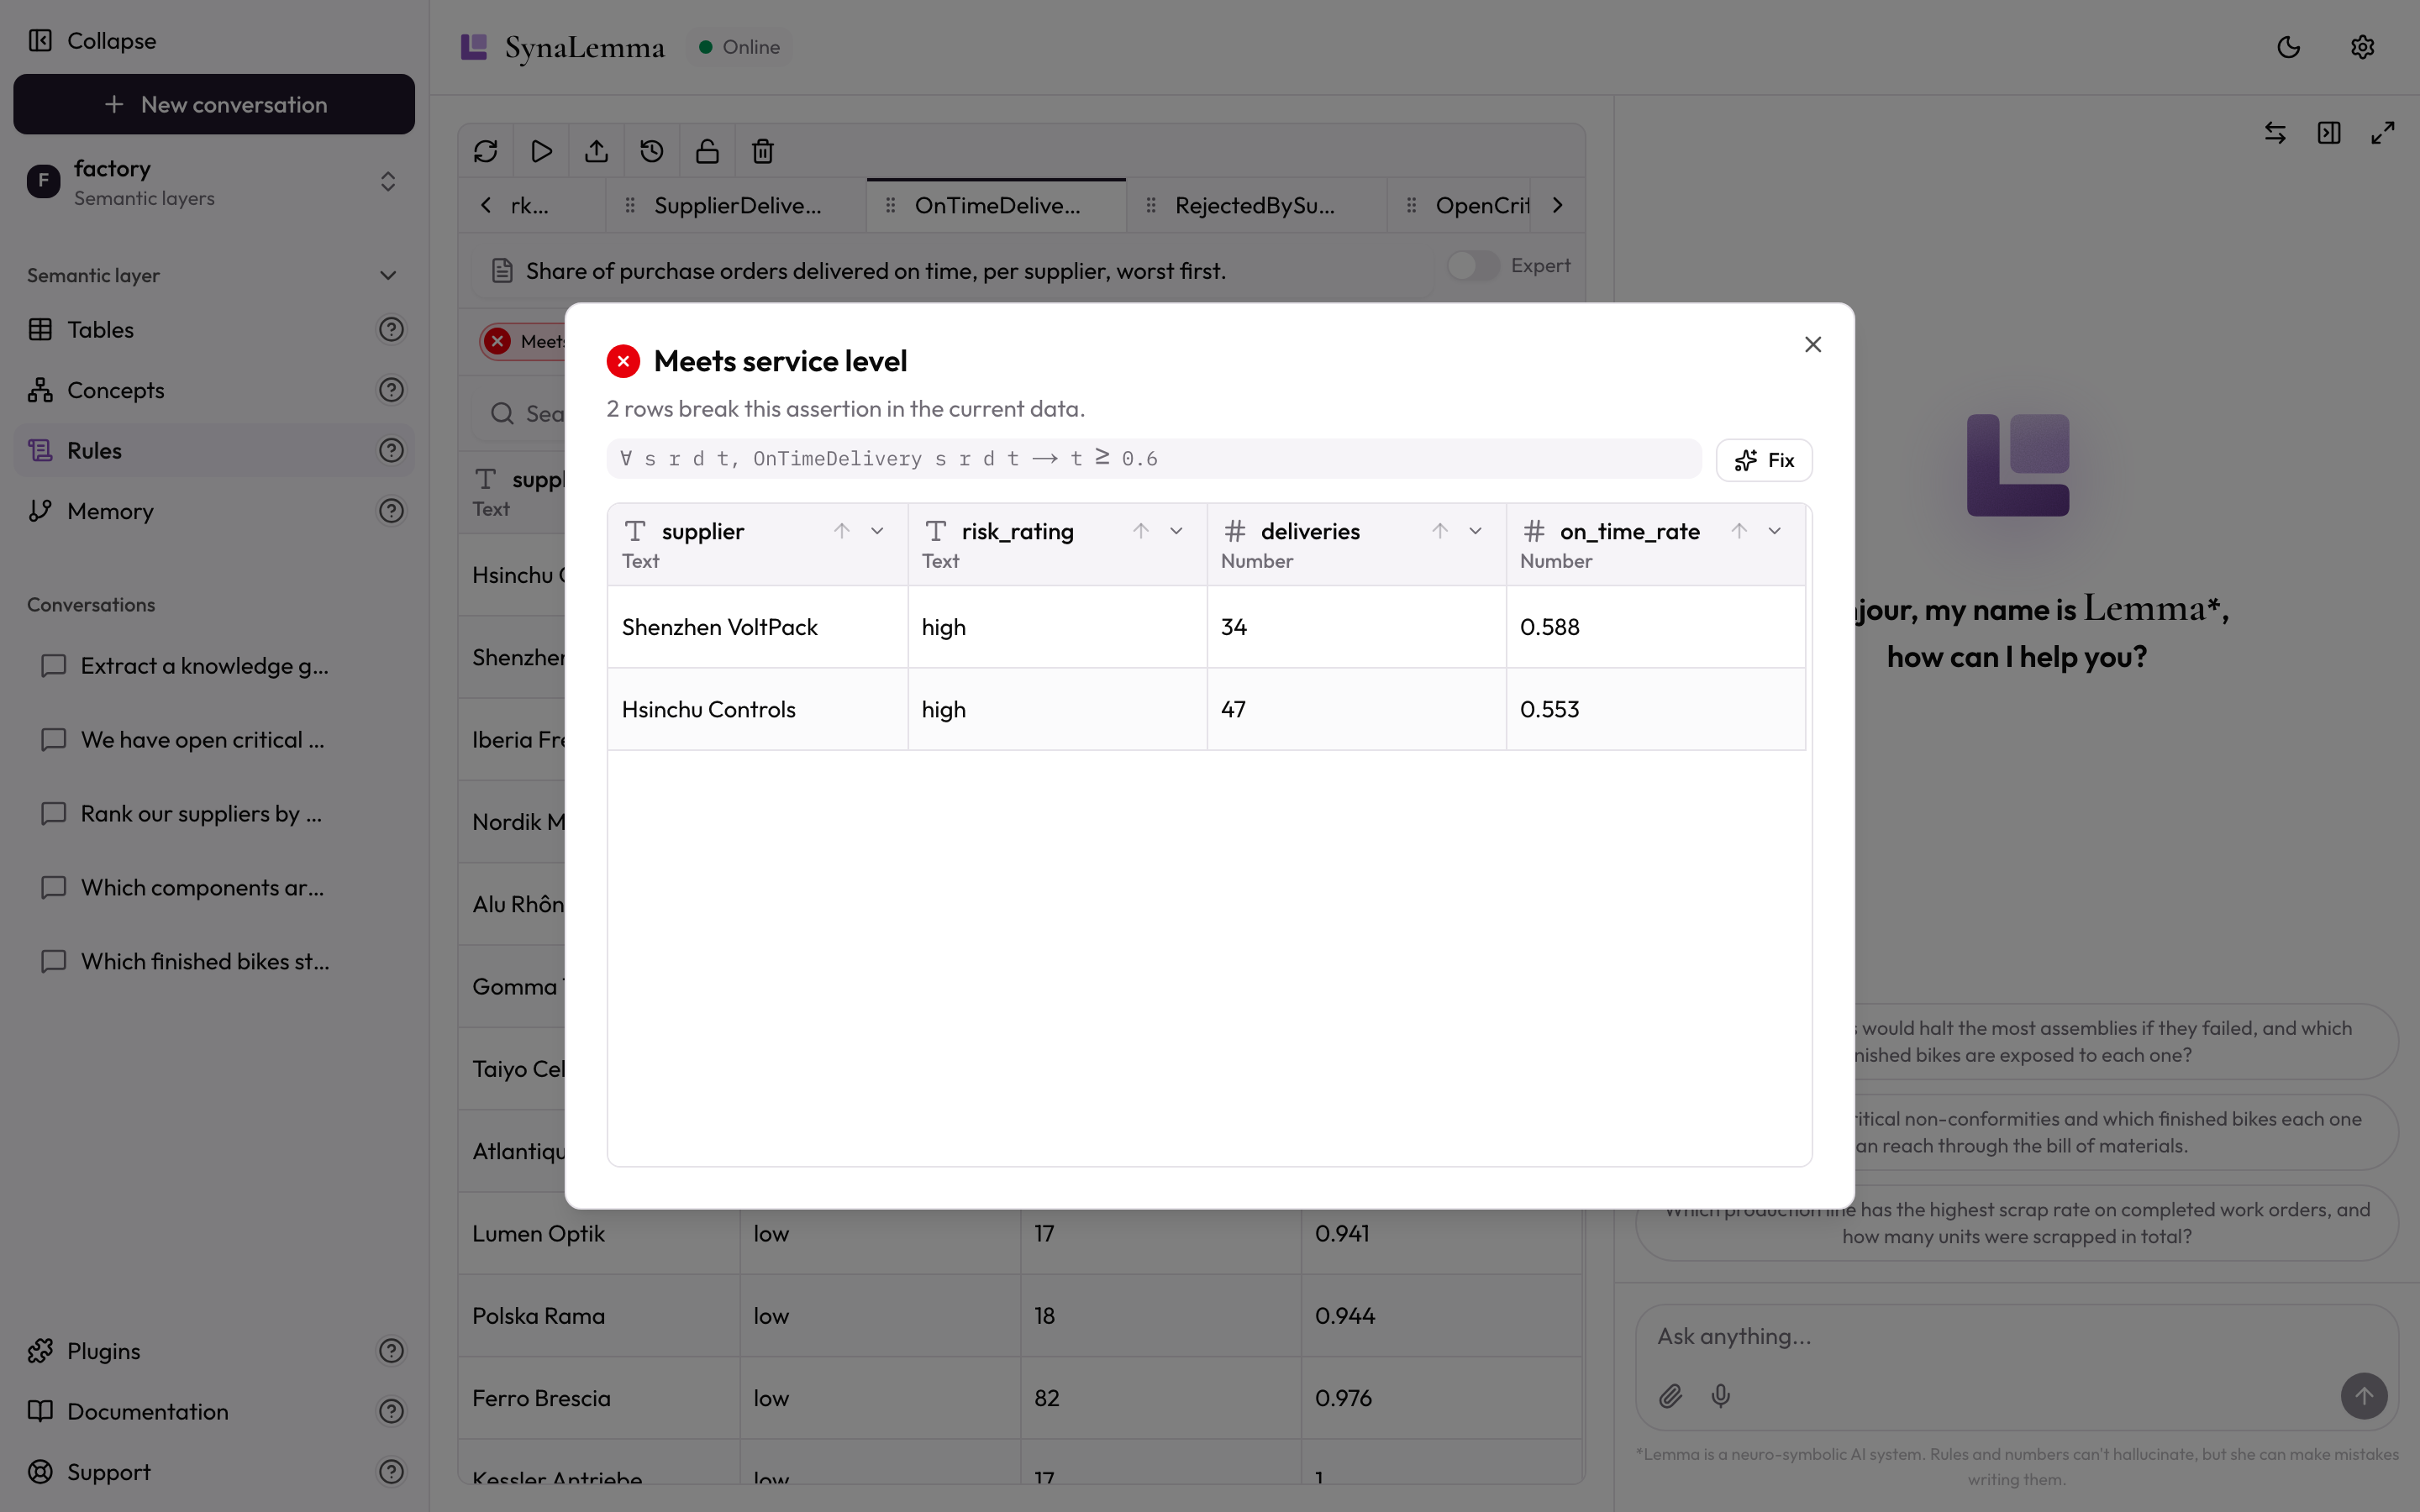
In SynaLemma is de layer een Synalog-programma: concepten en regels die deterministisch naar SQL compileren. De controle gebeurt door een symbolisch systeem, niet door een model. Voordat er SQL wordt uitgevoerd, bewijst de verifier dat elke regel welgevormd en veilig is en eindigt, en weigert hij elke regel die dat niet is. Asserties in eerste-orde logica worden op uw data gecontroleerd, en een assertie die faalt, komt terug met haar tegenvoorbeelden. Dezelfde regel compileert altijd naar dezelfde query, en elk antwoord is via benoemde regels terug te volgen tot uw tabellen.
Synalog kan ook uitdrukken wat een lijst SQL-fragmenten niet kan: regels die op andere regels voortbouwen, recursie (hiërarchieën, ketens over meerdere stappen), relaties tussen concepten en redeneren over tijd. Juist die strengheid maakt verificatie zinvol: een losjes getypeerd YAML-bestand heeft te weinig structuur om met een bewijs iets te zeggen.
Synalog is een echte programmeertaal en vraagt meer leerwerk dan een YAML-bestand. U hoeft het niet zelf te schrijven: het analyse-harness van SynaLemma schrijft en onderhoudt de regels, en de verifier controleert dat werk voordat het uw data bereikt. Wij hebben dat harness zelf geoptimaliseerd, met machine learning en ons opensourceframework Synalinks, zodat de analist draait op lokale modellen op uw eigen hardware, zonder kosten per token. Zonder een harness dat zo is afgestemd, vallen teams terug op frontiermodellen en betalen ze voor elke vraag. En omdat antwoorden uit gecompileerde regels komen in plaats van uit SQL die per vraag wordt gegenereerd, komt een kleiner model verder.
Lees de volledige vergelijking
Hoe verhouden SynaLemma en Synalog zich tot Apache Ossie?
Ze lossen verschillende problemen op. Ossie is een bestandsformaat: een leveranciersneutrale YAML-specificatie, in incubatie bij de Apache Software Foundation, om datasets, metrics en joins uit te wisselen tussen BI- en analysetools. Het voert geen query's uit. Elke tool die een Ossie-bestand leest, bepaalt zelf hoe het in SQL wordt omgezet, en de SQL voor elke database wordt met de hand in het bestand geschreven.
Synalog is een taal met een compiler. Eén programma compileert naar SQL voor PostgreSQL, BigQuery, Databricks, Trino, Presto, DuckDB en SQLite, en dezelfde regel compileert altijd naar dezelfde query.
Het verschil zit in wat elk kan uitdrukken. In de kernspecificatie van Ossie (een conceptspecificatie voor ontologieën voegt afgeleide concepten en recursieve relaties toe) kan een metric niet naar een andere metric verwijzen, een veld niet naar een ander veld, kan een dataset niet op een andere dataset voortbouwen, en is elke relatie een veel-op-een foreign key. Tijd is een vlag op een kolom. In Synalog bouwen regels voort op andere regels, zodat definities zich opstapelen in plaats van herhaald te worden. Het kan ook recursie aan (hiërarchieën, ketens over meerdere stappen), relaties tussen concepten en redeneren over tijd.
Het zit ook in wat er gecontroleerd kan worden. Een Ossie-bestand kan worden gevalideerd tegen zijn schema en zijn verwijzingen. Een Synalog-programma wordt gecontroleerd door een symbolische verifier, die voordat er SQL wordt uitgevoerd bewijst dat elke regel welgevormd en veilig is en eindigt. Asserties in eerste-orde logica worden op uw data gecontroleerd, met tegenvoorbeelden wanneer ze falen. Voor agents biedt Ossie hints in vrije tekst (ai_context) die een model kan lezen. De analist van SynaLemma schrijft Synalog-regels, en de verifier controleert ze voordat ze uw data raken.
SynaLemma is er voor definities die door agents moeten worden berekend, geverifieerd en uitgebreid, niet alleen uitgewisseld tussen tools.
Lees de volledige vergelijking
Hoe verhouden SynaLemma en Synalog zich tot semantic web-tools (RDF, OWL, SHACL)?
Beide beschrijven wat data betekent met concepten en relaties, en beide redeneren erover. Ze zijn gebouwd voor verschillende taken. Het semantic web beschrijft een domein zodat ontologieën kunnen worden gepubliceerd, gedeeld en tussen organisaties gekoppeld. Synalog beschrijft operationele ontologieën: alleen de concepten en relaties die uw data werkelijk bevat, elk gedefinieerd vanuit uw tabellen en daaruit berekend.
Dat verandert de logica. OWL werkt onder een open-wereldaanname: een feit dat in de graaf ontbreekt, is onbekend, niet onwaar, dus OWL alleen kan niet controleren dat elke bestelling een klant heeft. SHACL bestaat om dat gat te vullen, als tweede taal die de data valideert. Synalog is gesloten-wereld, zoals uw database: wat niet in de data staat, is onwaar. Regels, query's en beperkingen worden in één taal geschreven, en asserties controleren uw data rechtstreeks, met tegenvoorbeelden wanneer ze falen.
Het verandert ook de stack. Een semantic web-implementatie combineert meestal RDF voor de data, OWL voor de ontologie, SHACL voor validatie en SPARQL voor query's, plus een triplestore of een mappingtaal zoals R2RML om relationele tabellen te bereiken. Synalog is één taal die naar SQL compileert en draait op de databases die u al hebt.
Eenvoudiger betekent niet minder redeneren. Eén Synalog-programma kan recursie, aggregatie, negatie en redeneren over tijd combineren, en een symbolische verifier bewijst voordat het draait dat elke regel welgevormd en veilig is en eindigt. OWL-reasoners classificeren concepten; ze berekenen niet de totalen, gemiddelden en rangschikkingen die de meeste zakelijke vragen nodig hebben.
Synalog is ook gebouwd voor agents. De programma's zijn kort genoeg om door een model te worden geschreven en leesbaar genoeg om door een mens te worden nagekeken, en de analist van SynaLemma schrijft ze terwijl de vragen binnenkomen, elk gecontroleerd door de verifier voordat het uw data raakt. Semantic web-ontologieën worden meestal vooraf gemodelleerd, door specialisten: een project dat vaak maanden, niet zelden jaren, en een flink budget kost voordat de eerste vraag is beantwoord. Met SynaLemma groeit de layer vanaf de eerste vraag.
SynaLemma beantwoordt vragen over uw eigen data, met antwoorden die u kunt verifiëren, zonder voorafgaand modelleringsproject.
Lees de volledige vergelijking
Hoe verhouden SynaLemma en Synalog zich tot Cube?
Cube is een semantische layer en API, in YAML of JavaScript: cubes, views, measures, dimensies en joins, met caching en pre-aggregaties op veel databases. Net als Synalog compileert het query's vanuit zijn model voordat ze het datawarehouse bereiken, dus daar zit het verschil niet. Het zit in wat het model kan uitdrukken, en in wat het controleert.
In Cube is elke join een LEFT JOIN, en hiërarchieën zijn niveaus om in te zoomen, geen recursie. Rapportagelijnen, stuklijsten of afhankelijkheden over meerdere stappen passen niet in het model: daarvoor is een met de hand geschreven recursieve SQL-query nodig, zo moeilijk om goed te krijgen dat bijna niemand hem schrijft. In Synalog is graaftraversal onderdeel van de taal: een basisgeval en een recursieve stap, waarvan is geverifieerd dat ze eindigen, en die op elke engine draaien.
Cube controleert dat een model compileert, en de eigen documentatie waarschuwt dat een model dat compileert toch foute resultaten kan opleveren. De antwoorden van de agent worden gemeten met evaluaties tegen referentiequery's. Synalog bewijst dat elke regel welgevormd en veilig is en eindigt, en controleert de data met asserties in logica, met tegenvoorbeelden wanneer ze falen.
De AI-agent van Cube is onderdeel van Cube Cloud en schrijft Cube SQL op basis van uw vraag, standaard met gehoste modellen; een eigen model gebruiken is een optie van het Enterprise-abonnement. De analist van SynaLemma draait op een klein open model, op uw eigen infrastructuur.
SynaLemma is gebouwd voor de vragen die een dashboard-API met caching niet kan beantwoorden: de vragen die redeneren vereisen, met antwoorden die u kunt verifiëren.
Lees de volledige vergelijking
Hoe verhouden SynaLemma en Synalog zich tot de dbt Semantic Layer?
De dbt Semantic Layer, gebouwd op MetricFlow, definieert metrics in YAML bovenop dbt-modellen en compileert metric-query's naar SQL. De verschillen zitten in de uitdrukkingskracht, in de controles en in wat een agent kan bereiken.
MetricFlow biedt een vaste set metrictypen (simple, ratio, derived, cumulative, conversion), zonder eigen aggregaties, en joins van hooguit twee stappen. Recursie is er niet. In Synalog bouwen regels voort op andere regels zonder vaste catalogus, gaan joins zo ver als de vraag vereist, en is graaftraversal onderdeel van de taal, met geverifieerde beëindiging.
dbt valideert dat de semantische configuratie consistent is en dat de gegenereerde SQL draait, en dbt-tests kunnen tabellen controleren op sleutels, nullwaarden en verwijzingen. Synalog bewijst dat elke regel welgevormd en veilig is en eindigt voordat hij draait, en de asserties, in logica geschreven in een andere notatie dan de regels, gelden voor elke regel, ook recursieve en afgeleide: transitiviteit, totalen, geldigheidsperiodes.
De MCP-server van dbt geeft agents beheerde metric-query's, maar ook text-to-SQL en SQL-uitvoering die schrijfopdrachten niet blokkeert. De analist van SynaLemma heeft één weg naar uw data: via de geverifieerde layer, en een account met alleen leesrechten volstaat. De API's van de Semantic Layer vereisen bovendien een betaald abonnement op het dbt-platform; SynaLemma draait op uw infrastructuur met een klein open model.
SynaLemma gaat verder dan metrics opvragen: het redeneert over uw data, met antwoorden die u kunt verifiëren.
Lees de volledige vergelijking